Das Versprechen
Gut, Sie haben also Ihr schickes Large Language Model. Es schreibt Gedichte, fasst Dokumente zusammen und erzählt Ihnen sogar Witze. Großartig. Aber seien wir ehrlich: Meistens soll es tatsächlich etwas tun und nicht nur klug klingen. Und dieses Etwas bedeutet in der Regel, Daten in einem brauchbaren Format zurückzugeben.
Genau hier kommen strukturierte Ausgaben ins Spiel. Es geht um JSON, Dictionaries und vorhersagbare Formate. Kurz: um Daten, die Sie tatsächlich an Ihr Backend weiterleiten können, ohne sich die Haare zu raufen. Wenn Sie LLMs ernsthaft in Ihre Produktivsysteme integrieren wollen, statt nur herumzuspielen, ist das unverzichtbar. Es geht darum, vom beeindruckenden Partytrick zum nützlichen Werkzeug zu kommen.
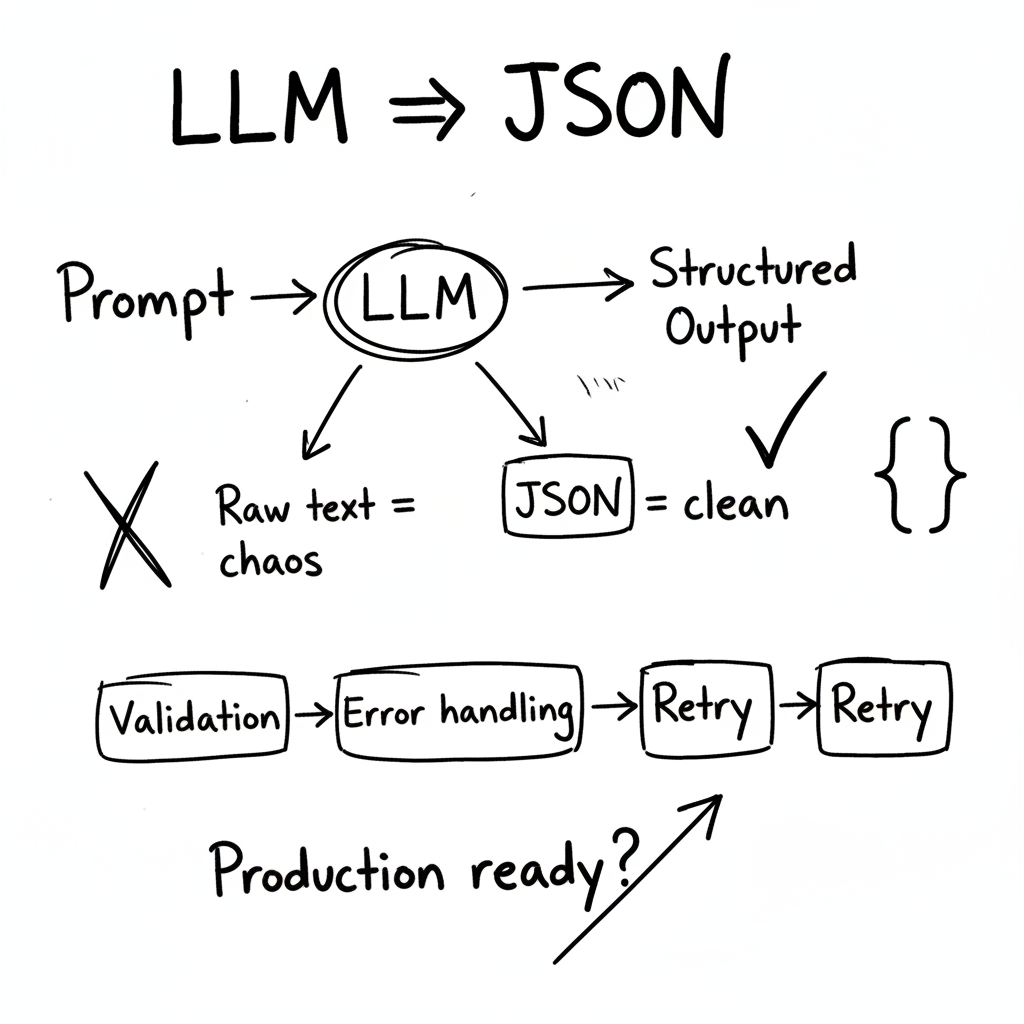
Unter der Haube
Das „LLM Structured Outputs Handbook“ geht das Thema direkt an und scheut zum Glück nicht vor den Details zurück. Es behandelt einige entscheidende Techniken:
- JSON-Modus: Das ist Ihr Ausgangspunkt. Einige Modelle haben inzwischen einen eingebauten JSON-Modus, und der hilft enorm. Er bringt das Modell dazu, direkt gültiges JSON zu erzeugen, und verringert so den Bedarf an Nachbearbeitung.
- Function Calling: Anspruchsvoller. Sie definieren eine Reihe von Funktionen (Name, Beschreibung und Parameter), und das LLM entscheidet, welche es aufruft, und füllt die Parameter mit passenden Daten. Das schafft einen engeren Kontrollkreis. Stellen Sie es sich so vor, als würden Sie Ihre API im Voraus definieren.
- Validierungsstrategien: Vertrauen Sie einem LLM nie blind. Validieren Sie die Ausgabe immer. Nutzen Sie Bibliotheken zur Schemavalidierung (etwa jsonschema in Python), um sicherzustellen, dass die Ausgabe der erwarteten Struktur entspricht. Das ist entscheidend, um Folgefehler weiter hinten in der Kette zu verhindern.
- Fehlerbehandlung: Es wird etwas schiefgehen. Das Modell halluziniert vielleicht, das JSON ist fehlerhaft, der Funktionsaufruf schlägt fehl. Das Handbook beschreibt vermutlich Strategien, um mit solchen Fehlern sauber umzugehen. Dazu gehören Wiederholungsmechanismen, Ausweichoptionen und klare Fehlermeldungen. Werfen Sie nicht einfach die Hände in die Luft, sondern planen Sie das Scheitern ein.
Unsere Einschätzung
Nach einigen Jahren im Ringen mit Backend-Systemen kann ich Ihnen sagen: Zuverlässige Daten in einem vorhersagbaren Format zu bekommen, ist die halbe Miete. Dieses Handbook klingt nach einer wirklich nützlichen Ressource. Aus eigener Erfahrung würde ich ein paar Punkte besonders betonen:
- Einfach anfangen: Versuchen Sie nicht, zu clever zu sein. Beginnen Sie, wo verfügbar, mit dem JSON-Modus und führen Sie Function Calling schrittweise ein, wenn Ihre Anforderungen komplexer werden.
- Testen, testen, testen: Sie brauchen eine solide Testsuite, die verschiedene Szenarien abdeckt. Dazu gehören positive und negative Testfälle. Denken Sie an Grenzfälle: Was passiert, wenn das Modell unerwartete Eingaben erhält?
- Prompt Engineering ist entscheidend: Ihre Prompts müssen das erwartete Ausgabeformat glasklar beschreiben. Nutzen Sie Beispiele in Ihren Prompts, um das Modell zu lenken. Je präziser Sie sind, desto besser die Ergebnisse.
- Die Logs nicht vergessen: Umfassendes Logging ist unverzichtbar, um Ihre LLM-Integrationen zu debuggen und zu überwachen. Protokollieren Sie die Eingabe, die Ausgabe und alle aufgetretenen Fehler. So erkennen Sie Muster und verbessern mit der Zeit die Zuverlässigkeit Ihres Systems.
- Iterieren und verfeinern: Die Integration von LLMs ist ein iterativer Prozess. Erwarten Sie nicht, dass es beim ersten Mal klappt. Überwachen Sie laufend die Leistung Ihres Systems und verfeinern Sie Ihre Prompts, Validierungsstrategien und Mechanismen zur Fehlerbehandlung.
Letztlich geht es im „LLM Structured Outputs Handbook“ darum, etwas technische Disziplin in den Wilden Westen der Large Language Models zu bringen. Es geht darum, sie nutzbar, zuverlässig und, ich wage es zu sagen, langweilig genug für den praktischen Einsatz zu machen. Und das ist für mich eine sehr gute Sache.