Wie Adidas Databricks nutzt
adidas built a RAG chatbot on Databricks that analyzes sentiment across more than 2 million customer product reviews. It lets product, design, marketing and customer service teams, including nontechnical users, get insights from customer feedback.
Erfassten Nachweis ansehenDer Anwendungsfall: wie Adidas Databricks einsetzt
adidas built a GenAI RAG chatbot on Databricks that analyzes sentiment across more than 2 million product reviews and gives product teams, including nontechnical users, actionable insights from customer feedback.
Weitere angegebene Ergebnisse
Zahlen aus der Fallstudie von Databricks. usedby hat sie nicht unabhängig gemessen.
More efficient prompt engineering and smaller context windows reduced token input size by 98.5%, from 200,000 to just 3,000 tokens per query.
Through GenAI, adidas improved review analysis efficiency by up to 30–40%, cutting down extensive manual workloads across global teams.
91.67% cost savings
In den Worten des Kunden
The GenAI infrastructure we built is already enabling use cases beyond product reviews,Weitere KI-Tools von Adidas
Weitere öffentliche Beziehungen, die auf usedby erfasst sind.
Den KI-Stack von Adidas ansehen
Nutzer von Databricks in der Branche Mode & Bekleidung
Unternehmen derselben Branche, mit öffentlichen Belegen.
Alle Kunden von Databricks ansehen
Direkt zur Quelle
Auf Basis der veröffentlichten Fallstudie von Databricks. Wir prüfen die öffentlichen Belege; die Ergebnisse gibt der Anbieter an.
databricks.com- Zuletzt geprüft
- 3. Okt. 2026
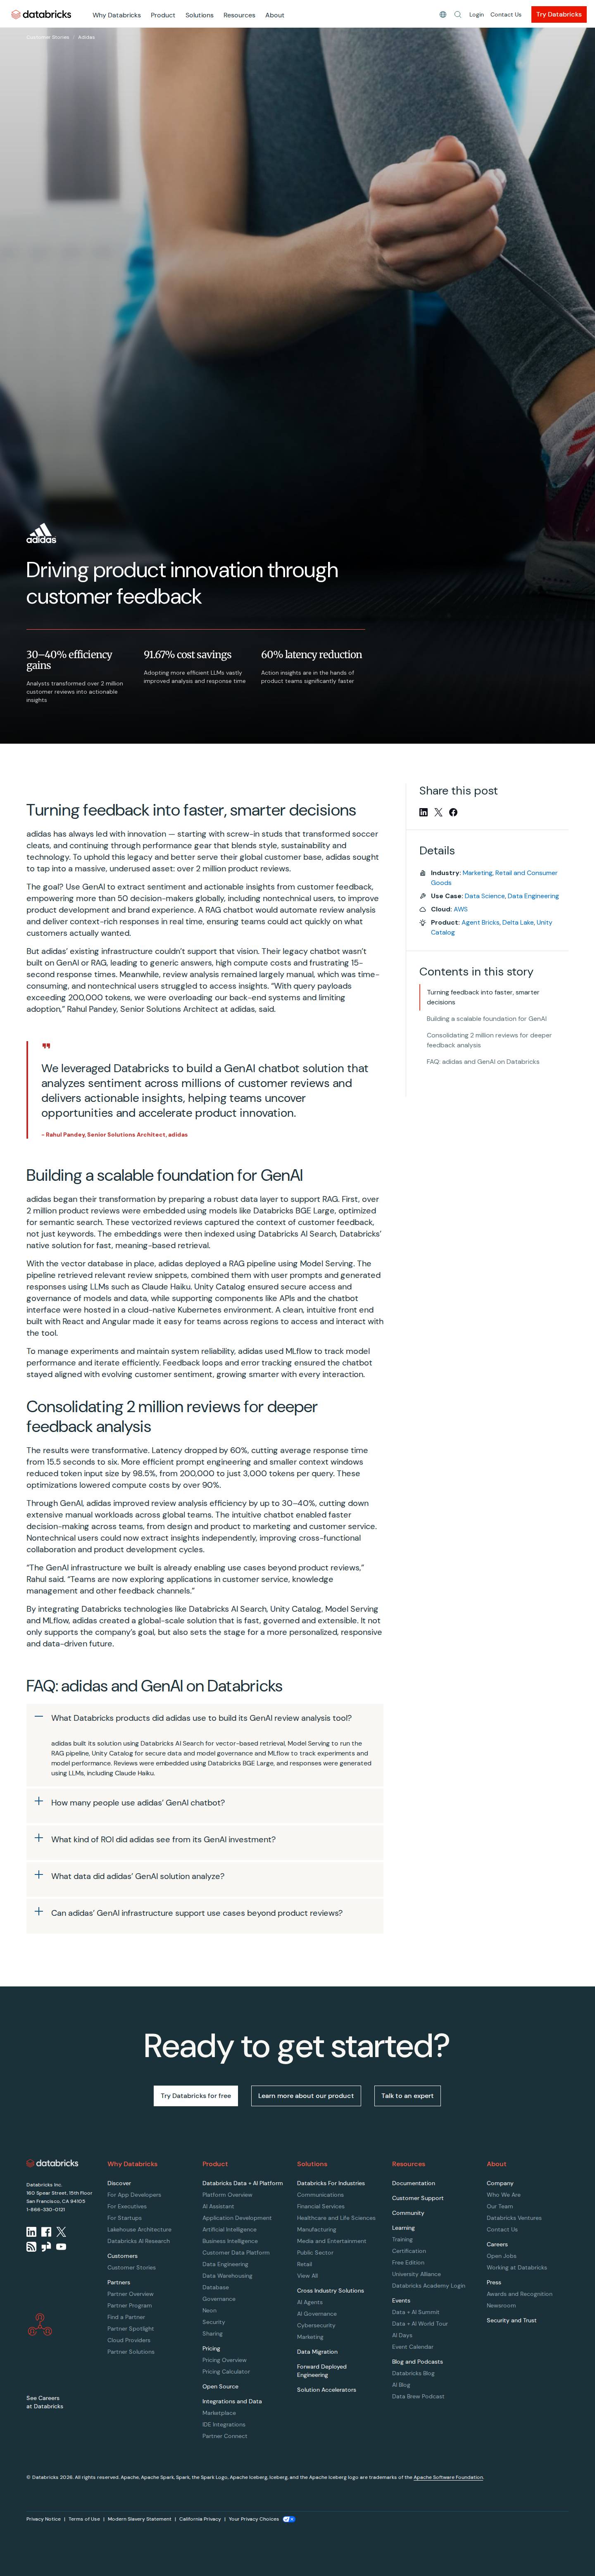 Screenshot der Quelle öffnen
Was die Fallstudie behauptet und was wir geprüft haben
Was wir mit der Seite verglichen haben.
- Die Zahl: 60%Geprüft
Steht wörtlich auf der Seite, nahe dem Namen Adidas.
- Die oben zitierte PassageGeprüft
Wörtlich von der Seite übernommen, nahe dem Namen Adidas.
- Die Zahlen in unserer ZusammenfassungGeprüft
Jede steht auf der Seite.
- Adidas nutzt DatabricksGeprüft
Eintrag mit Stufe Bestätigt.
- Das Ergebnis selbstNicht geprüft
Wir zitieren es; wir haben es nicht gemessen.
Latency dropped by 60%, cutting average response time from 15.5 seconds to six. More efficient prompt engineering and smaller context windows reduced token input size by 98.5%, from 200,000 to just 3,000 tokens per query.