Der Anwendungsfall: wie Cartesia Together AI einsetzt
Cartesia runs production real-time voice serving and model training on Together AI's GPU clusters. It operates a custom inference engine for its State Space Model architecture with cluster-level access, and uses PCI-compliant environments for regulated enterprise customers.
In den Worten des Kunden
Because our voice models use state space architectures, we need to run a purpose-built inference engine. Together AI gives us the compute and cluster-level access we need—down to the filesystem and SSH permissions—so we can optimize our serving stack exactly how we want. They manage the heavy lifting of the hardware orchestration and ingress, and we get the low-level control required to hit our streaming latency targets.Weitere KI-Tools von Cartesia
Weitere öffentliche Beziehungen, die auf usedby erfasst sind.
Den KI-Stack von Cartesia ansehen
Nutzer von Together AI in der Branche Künstliche Intelligenz
Unternehmen derselben Branche, mit öffentlichen Belegen.
 Arcee AIBestätigt
 DecagonBestätigt
 Deep CogitoBestätigt
 Dippy AIBestätigt
 HedraBestätigt
 LegionEdgeBestätigt
Direkt zur Quelle
Auf Basis der veröffentlichten Fallstudie von Together AI. Wir prüfen die öffentlichen Belege; die Ergebnisse gibt der Anbieter an.
together.ai- Zuletzt geprüft
- 3. Okt. 2026
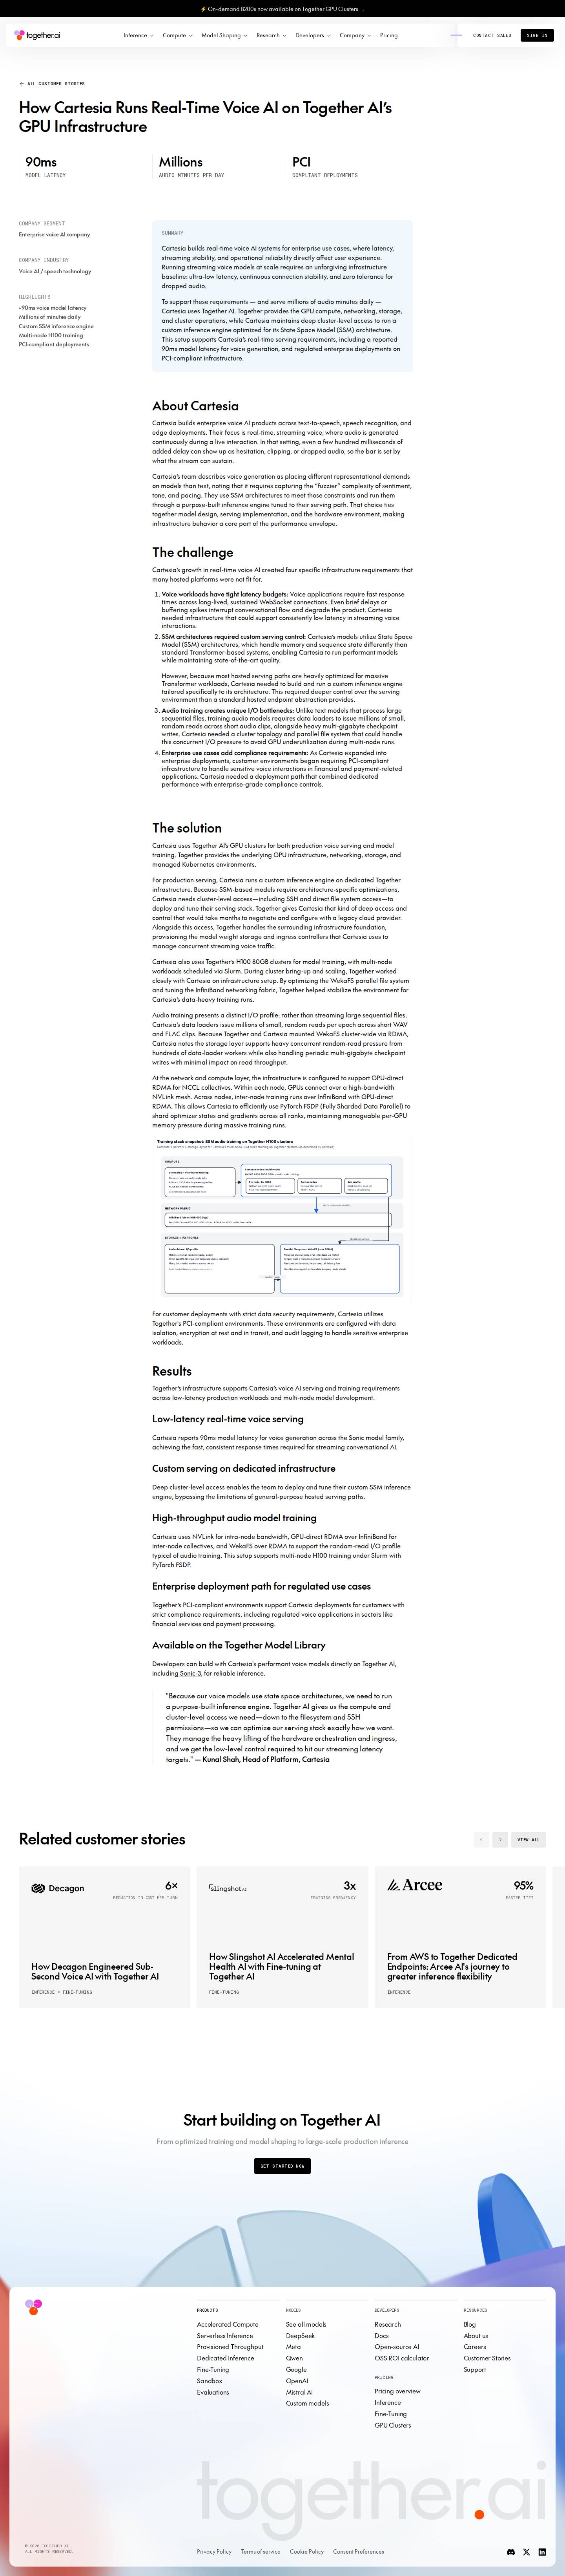 Screenshot der Quelle öffnen
Was die Fallstudie behauptet und was wir geprüft haben
Was wir mit der Seite verglichen haben.
- Die oben zitierte PassageGeprüft
Wörtlich von der Seite übernommen, nahe dem Namen Cartesia.
- Cartesia nutzt Together AIGeprüft
Eintrag mit Stufe Bestätigt.
- Das Ergebnis selbstNicht geprüft
Wir zitieren es; wir haben es nicht gemessen.
Cartesia reports 90ms model latency for voice generation across the Sonic model family, achieving the fast, consistent response times required for streaming conversational AI.