Der Anwendungsfall: wie Decagon Together AI einsetzt
Decagon runs production inference for its multi-model voice AI agents on Together AI, using hosted open-source and fine-tuned models on NVIDIA B200 GPUs. Together also helped train custom speculative decoding draft models and tune deployments to meet strict latency budgets.
Weitere angegebene Ergebnisse
Zahlen aus der Fallstudie von Together AI. usedby hat sie nicht unabhängig gemessen.
Decagon reduced p95 model latency per turn from seconds to <400ms on inputs up to tens of thousands of tokens.
In den Worten des Kunden
Low latency is especially important for voice because there’s a much higher UX bar. Together helped us push latency down by optimizing our models with techniques like speculative decoding, and they’ve been a reliable production partner — proactive about risks and fast when issues come up.Weitere KI-Tools von Decagon
Weitere öffentliche Beziehungen, die auf usedby erfasst sind.
Den KI-Stack von Decagon ansehen
Nutzer von Together AI in der Branche Künstliche Intelligenz
Unternehmen derselben Branche, mit öffentlichen Belegen.
 Arcee AIBestätigt
 CartesiaBestätigt
 Deep CogitoBestätigt
 Dippy AIBestätigt
 HedraBestätigt
 LegionEdgeBestätigt
Direkt zur Quelle
Auf Basis der veröffentlichten Fallstudie von Together AI. Wir prüfen die öffentlichen Belege; die Ergebnisse gibt der Anbieter an.
together.ai- Zuletzt geprüft
- 3. Okt. 2026
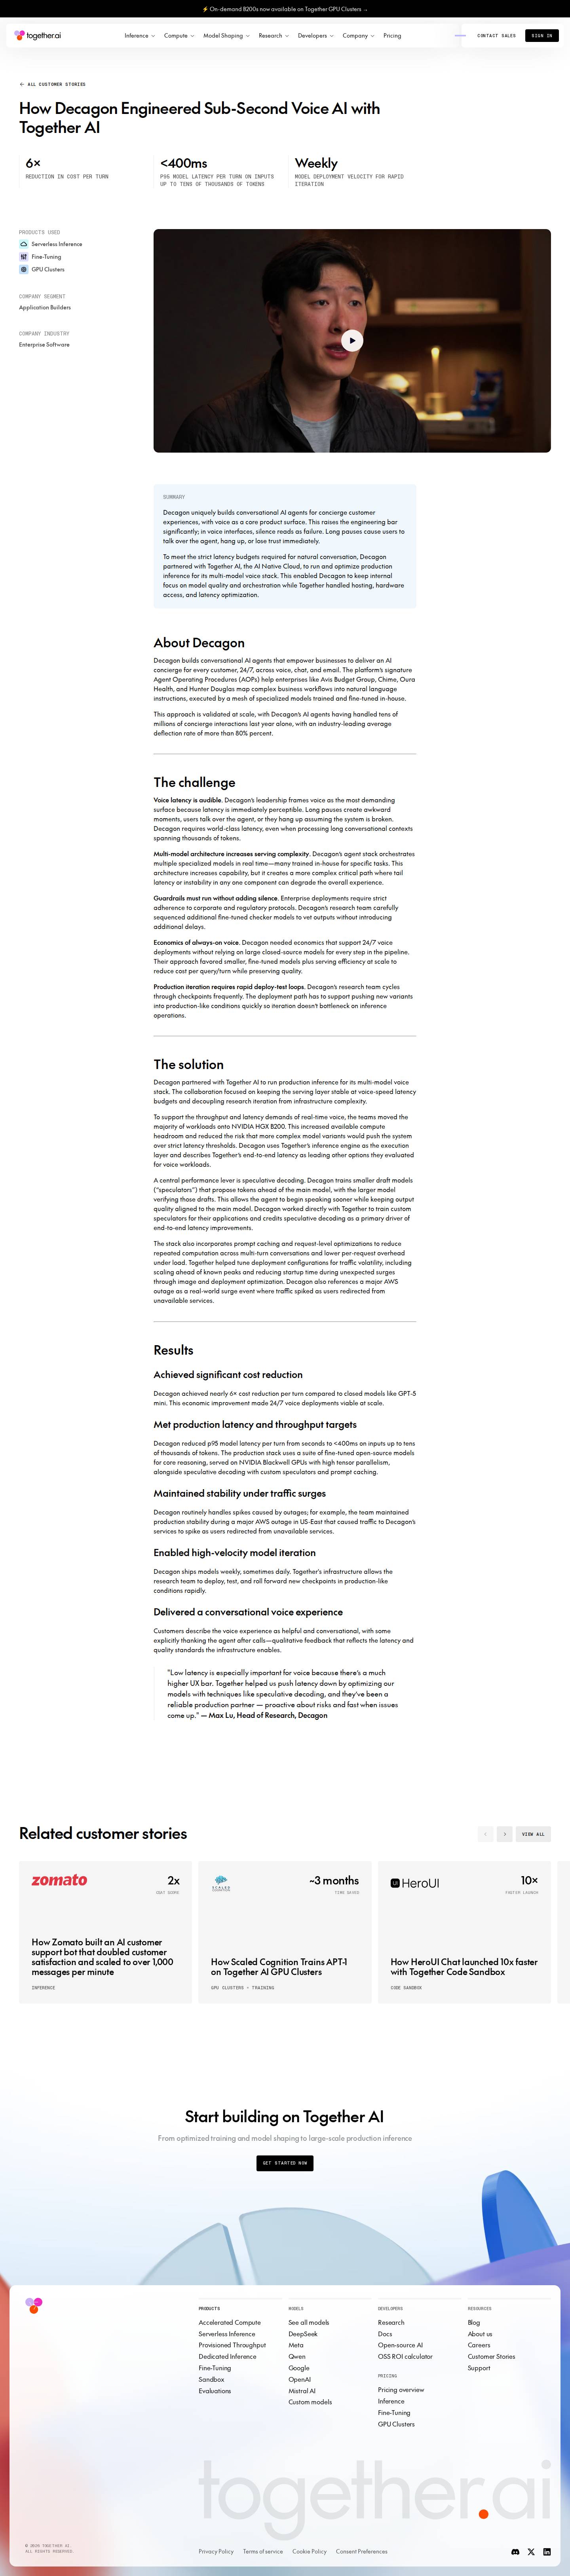 Screenshot der Quelle öffnen
Was die Fallstudie behauptet und was wir geprüft haben
Was wir mit der Seite verglichen haben.
- Die Zahl: 6×Geprüft
Steht wörtlich auf der Seite, nahe dem Namen Decagon.
- Die oben zitierte PassageGeprüft
Wörtlich von der Seite übernommen, nahe dem Namen Decagon.
- Decagon nutzt Together AIGeprüft
Eintrag mit Stufe Bestätigt.
- Das Ergebnis selbstNicht geprüft
Wir zitieren es; wir haben es nicht gemessen.
Decagon achieved nearly 6× cost reduction per turn compared to closed models like GPT-5 mini. This economic improvement made 24/7 voice deployments viable at scale.