Der Anwendungsfall: wie OpenEvidence Baseten einsetzt
OpenEvidence, a medical search platform, uses Baseten Training to train its custom, domain-specific open-source models. Its machine learning team runs many training jobs in parallel on on-demand GPUs to test different hyperparameter settings and then deploys the models to production inference.
Weitere angegebene Ergebnisse
Zahlen aus der Fallstudie von Baseten. usedby hat sie nicht unabhängig gemessen.
even non-ML engineers could get results in under 30 minutes
In den Worten des Kunden
Baseten helped us train models to be 23x faster and is projected to save us $1.9M—while making the process so easy that even non-ML engineers could get results in under 30 minutes.Our team spent weeks researching and vetting inference providers. It was a thorough process and we confidently believe Baseten is a clear winner.Weitere KI-Tools von OpenEvidence
Weitere öffentliche Beziehungen, die auf usedby erfasst sind.
Den KI-Stack von OpenEvidence ansehen
Nutzer von Baseten in der Branche HealthTech & digitale Gesundheit
Unternehmen derselben Branche, mit öffentlichen Belegen.
Alle Kunden von Baseten ansehen
Direkt zur Quelle
Auf Basis der veröffentlichten Fallstudie von Baseten. Wir prüfen die öffentlichen Belege; die Ergebnisse gibt der Anbieter an.
baseten.co- Quelle veröffentlicht
- 20. Feb. 2026
- Zuletzt geprüft
- 10. Okt. 2026
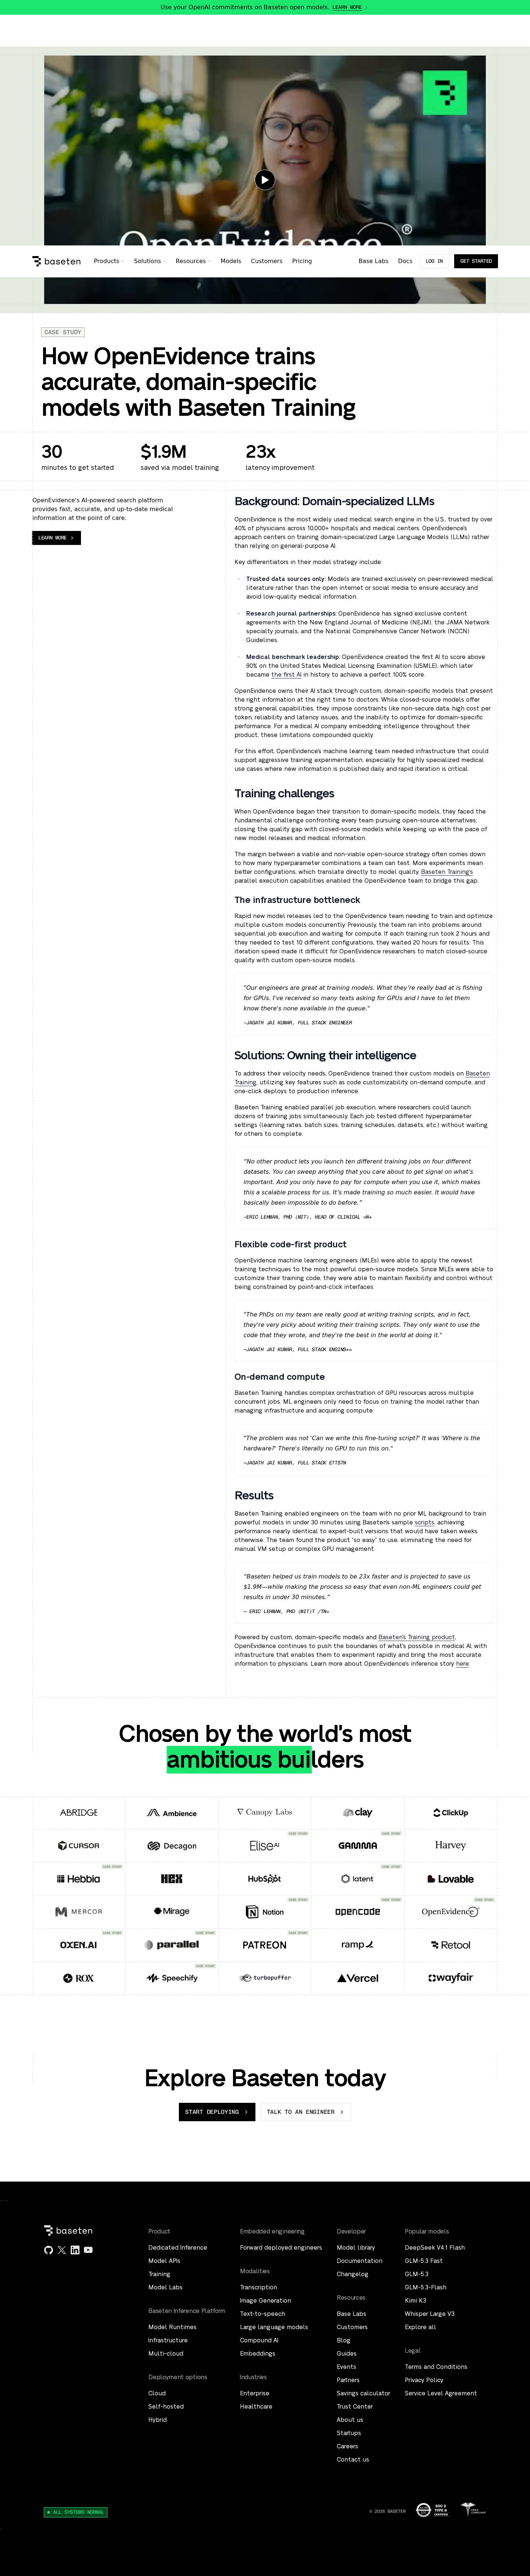 Screenshot der Quelle öffnen
Was die Fallstudie behauptet und was wir geprüft haben
Was wir mit der Seite verglichen haben.
- Die Zahl: 23xGeprüft
Die Zahl steht auf der Seite; ihre Beschriftung ist unsere Formulierung.
- Die oben zitierte PassageGeprüft
Wörtlich von der Seite übernommen, nahe dem Namen OpenEvidence.
- Das VeröffentlichungsdatumGeprüft
Aus den eigenen Metadaten der Seite gelesen, nie geschätzt.
- OpenEvidence nutzt BasetenGeprüft
Eintrag mit Stufe Bestätigt.
- Das Ergebnis selbstNicht geprüft
Wir zitieren es; wir haben es nicht gemessen.
“Baseten helped us train models to be 23x faster and is projected to save us $1.9M—while making the process so easy that even non-ML engineers could get results in under 30 minutes.”