Der Anwendungsfall: wie Rime Baseten einsetzt
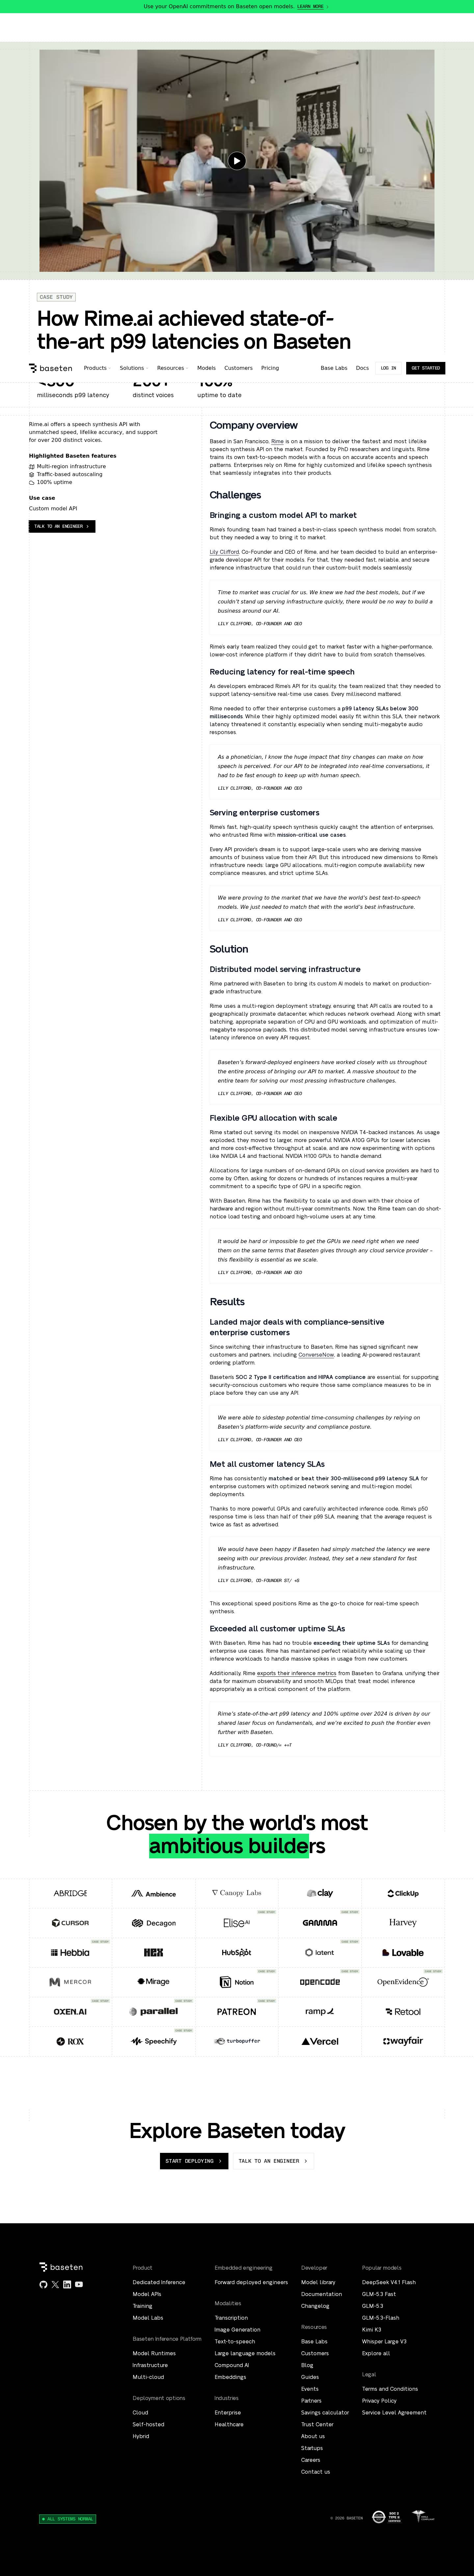
Rime trains its own text-to-speech models and serves them through an enterprise API on Baseten's multi-region inference infrastructure. This lets it meet real-time latency and uptime requirements and scale GPU capacity as customer demand grows.
Weitere angegebene Ergebnisse
Zahlen aus der Fallstudie von Baseten. usedby hat sie nicht unabhängig gemessen.
Rime.ai offers a speech synthesis API with unmatched speed, lifelike accuracy, and support for over 200 distinct voices.
In den Worten des Kunden
It would be hard or impossible to get the GPUs we need right when we need them on the same terms that Baseten gives through any cloud service provider – this flexibility is essential as we scale.Weitere KI-Tools von Rime
Weitere öffentliche Beziehungen, die auf usedby erfasst sind.
Den KI-Stack von Rime ansehen
Nutzer von Baseten in der Branche Künstliche Intelligenz
Unternehmen derselben Branche, mit öffentlichen Belegen.
 EliseAIBestätigt
 GammaBestätigt
 HebbiaBestätigt
 Oxen AIBestätigt
 Parallel Web SystemsBestätigt
 PoolsideBestätigt
Direkt zur Quelle
Auf Basis der veröffentlichten Fallstudie von Baseten. Wir prüfen die öffentlichen Belege; die Ergebnisse gibt der Anbieter an.
baseten.co- Quelle veröffentlicht
- 23. Okt. 2024
- Zuletzt geprüft
- 9. Okt. 2026
 Screenshot der Quelle öffnen
Was die Fallstudie behauptet und was wir geprüft haben
Was wir mit der Seite verglichen haben.
- Die Zahl: <300Geprüft
Die Zahl steht auf der Seite; ihre Beschriftung ist unsere Formulierung.
- Die oben zitierte PassageGeprüft
Wörtlich von der Seite übernommen, nahe dem Namen Rime.
- Das VeröffentlichungsdatumGeprüft
Aus den eigenen Metadaten der Seite gelesen, nie geschätzt.
- Rime nutzt BasetenGeprüft
Eintrag mit Stufe Bestätigt.
- Das Ergebnis selbstNicht geprüft
Wir zitieren es; wir haben es nicht gemessen.
Rime has consistently matched or beat their 300-millisecond p99 latency SLA for enterprise customers with optimized network serving and multi-region model deployments.