O pitch
Muito bem, você tem o seu sofisticado Large Language Model. Ele escreve poemas, resume documentos e até conta piadas. Ótimo. Mas, sejamos honestos: na maior parte do tempo, você precisa que ele faça alguma coisa, e não só que pareça inteligente. E essa coisa geralmente envolve devolver dados em um formato utilizável.
É aí que entram as saídas estruturadas. Estamos falando de JSON, dicionários, formatos previsíveis. Basicamente, o tipo de coisa que você consegue mandar direto para o backend sem querer arrancar os cabelos. Se você leva a sério a integração de LLMs aos seus sistemas de produção, e não está só brincando, isso é inegociável. Trata-se de passar de um truque de salão impressionante para uma ferramenta útil.
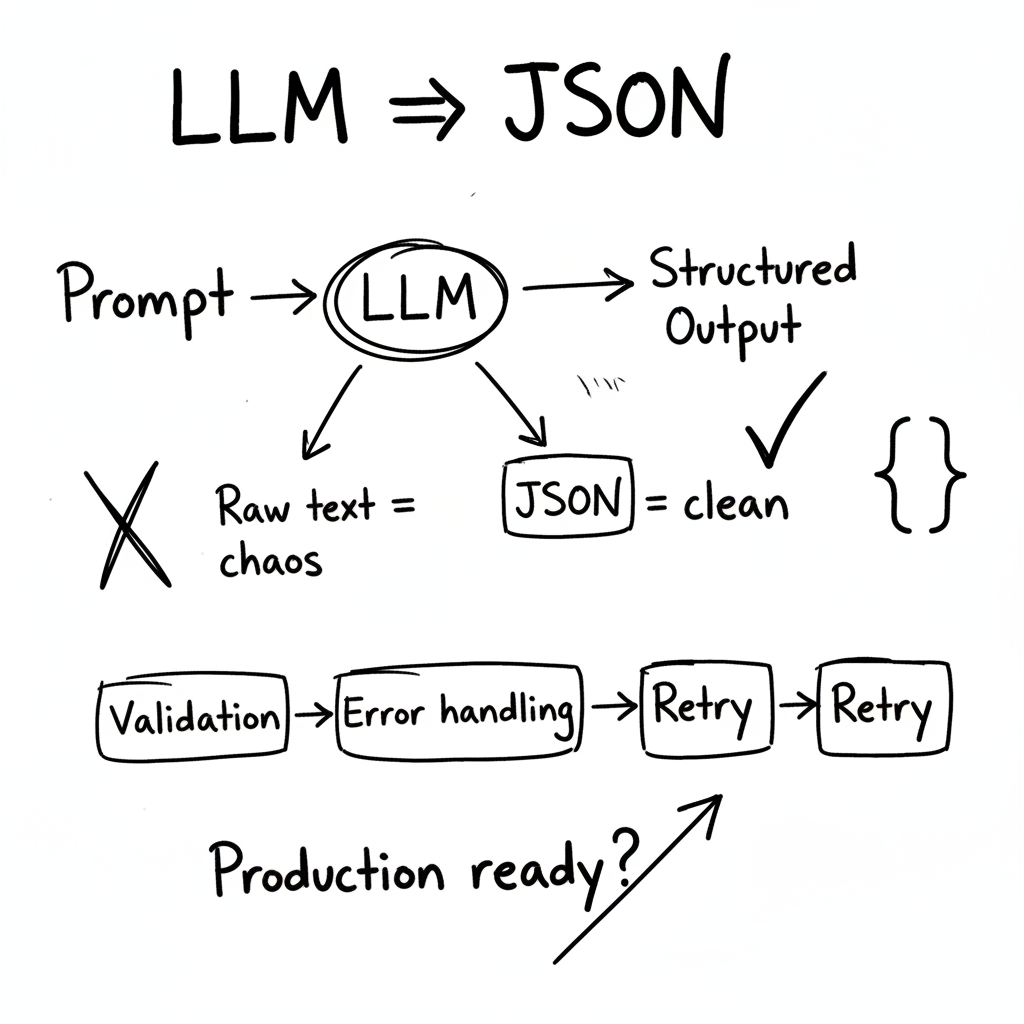
Por dentro
O “LLM Structured Outputs Handbook” enfrenta o problema de frente e, felizmente, não foge dos detalhes. Ele aborda algumas técnicas essenciais:
- Modo JSON: este é o seu ponto de partida. Alguns modelos já têm um modo JSON nativo, o que ajuda muito. Ele induz o modelo a produzir JSON válido diretamente, reduzindo a necessidade de pós-processamento.
- Function calling: mais sofisticado. Você define um conjunto de funções (nome, descrição e parâmetros) e o LLM decide qual chamar, preenchendo os parâmetros com os dados relevantes. Isso oferece um ciclo de controle mais rigoroso. Pense nisso como definir sua API logo de início.
- Estratégias de validação: nunca confie cegamente em um LLM. Valide sempre a saída. Use bibliotecas de validação de esquema (como jsonschema em Python) para garantir que a saída siga a estrutura esperada. Isso é crucial para evitar erros em cascata mais adiante.
- Recuperação de erros: as coisas vão dar errado. O modelo pode alucinar, o JSON pode vir malformado, a chamada de função pode falhar. O Handbook provavelmente detalha estratégias para lidar com esses erros de forma elegante. Isso inclui mecanismos de nova tentativa, opções de fallback e relatórios de erro claros. Não jogue a toalha: planeje para a falha.
Nossa opinião
Depois de passar bons anos brigando com sistemas de backend, posso garantir que obter dados confiáveis em um formato previsível é metade da batalha. Este Handbook parece ser um recurso realmente útil. Aqui estão alguns pontos que eu destacaria, com base na minha própria experiência:
- Comece simples: não tente ser esperto demais. Comece com o modo JSON quando disponível e depois introduza function calling aos poucos, à medida que seus requisitos ficarem mais complexos.
- Teste, teste, teste: você precisa de uma suíte de testes robusta para cobrir diferentes cenários. Ela deve incluir casos de teste positivos e negativos. Pense nos casos-limite: o que acontece quando o modelo recebe uma entrada inesperada?
- Prompt engineering é fundamental: seus prompts precisam ser cristalinos sobre o formato de saída esperado. Use exemplos nos prompts para guiar o modelo. Quanto mais preciso você for, melhores serão os resultados.
- Não se esqueça dos logs: um registro completo em log é essencial para depurar e monitorar suas integrações com LLMs. Registre a entrada, a saída e todos os erros encontrados. Isso vai ajudar você a identificar padrões e melhorar a confiabilidade do seu sistema ao longo do tempo.
- Itere e refine: a integração de LLMs é um processo iterativo. Não espere acertar de primeira. Monitore continuamente o desempenho do seu sistema e refine seus prompts, suas estratégias de validação e seus mecanismos de tratamento de erros.
No fim das contas, o “LLM Structured Outputs Handbook” trata de trazer alguma disciplina de engenharia para o velho oeste dos Large Language Models. Trata de torná-los utilizáveis, confiáveis e, ouso dizer, entediantes o bastante para aplicações do mundo real. E isso, na minha opinião, é uma coisa muito boa.