Como Adidas usa Databricks
adidas built a RAG chatbot on Databricks that analyzes sentiment across more than 2 million customer product reviews. It lets product, design, marketing and customer service teams, including nontechnical users, get insights from customer feedback.
Ver a prova capturadaO caso de uso: como Adidas implanta Databricks
adidas built a GenAI RAG chatbot on Databricks that analyzes sentiment across more than 2 million product reviews and gives product teams, including nontechnical users, actionable insights from customer feedback.
Outros resultados informados
Números publicados no estudo de caso de Databricks. Eles não são medidos de forma independente pelo usedby.
More efficient prompt engineering and smaller context windows reduced token input size by 98.5%, from 200,000 to just 3,000 tokens per query.
Through GenAI, adidas improved review analysis efficiency by up to 30–40%, cutting down extensive manual workloads across global teams.
91.67% cost savings
Nas palavras do cliente
The GenAI infrastructure we built is already enabling use cases beyond product reviews,Outras ferramentas de IA usadas por Adidas
Outras relações públicas registradas no usedby.
Explorar a stack de IA de Adidas
Usuários de Databricks no setor Moda e vestuário
Empresas do mesmo setor, com evidências públicas.
Ver todos os clientes de Databricks
Ir direto à fonte
Com base no estudo de caso publicado por Databricks. Verificamos as evidências públicas; os resultados são informados pelo fornecedor.
databricks.com- Última verificação
- 3 de out. de 2026
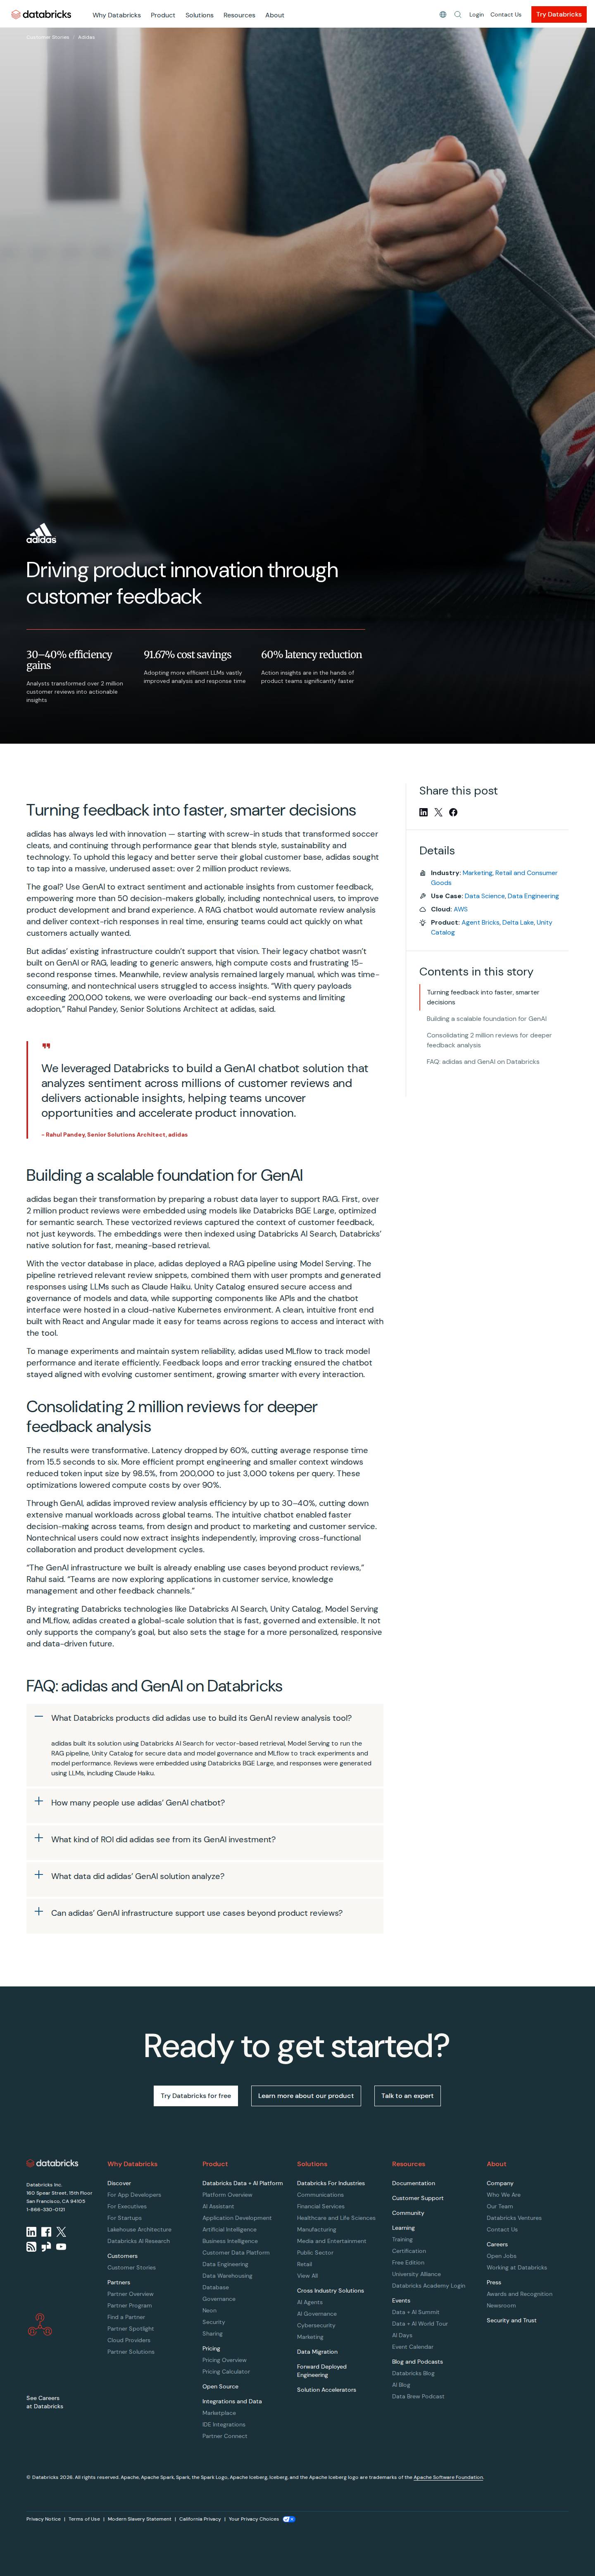 Abrir a captura da fonte
O que o estudo de caso afirma e o que verificamos
O que comparamos com a página.
- O número: 60%Verificado
Impresso palavra por palavra na página, perto do nome de Adidas.
- O trecho citado acimaVerificado
Copiado palavra por palavra da página, perto do nome de Adidas.
- Os números do nosso resumoVerificado
Cada um está impresso na página.
- Adidas usa DatabricksVerificado
Linha de nível Confirmado.
- O resultado em siNão verificado
Nós o citamos; não o medimos.
Latency dropped by 60%, cutting average response time from 15.5 seconds to six. More efficient prompt engineering and smaller context windows reduced token input size by 98.5%, from 200,000 to just 3,000 tokens per query.