O caso de uso: como Rime implanta Baseten
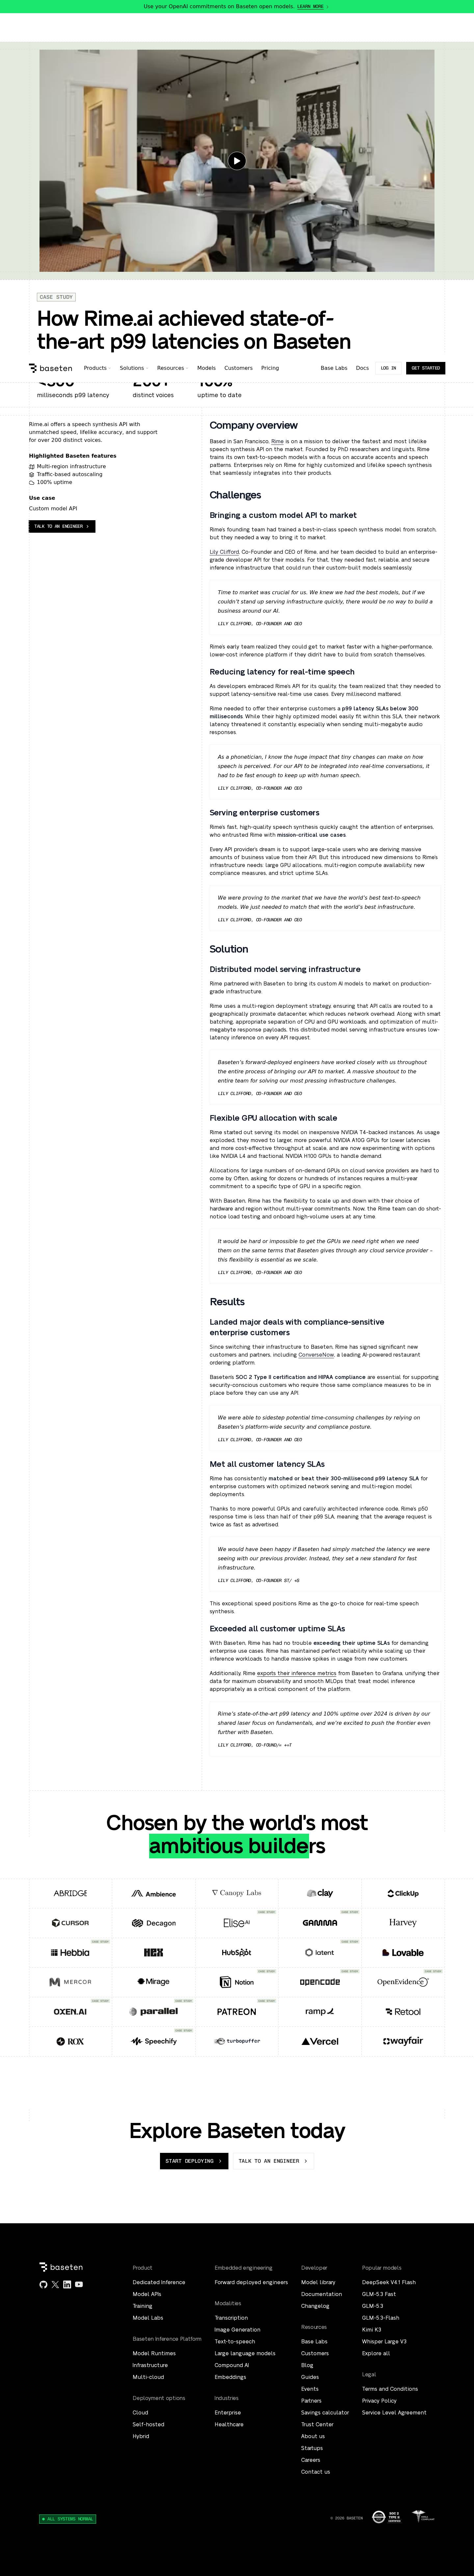
Rime trains its own text-to-speech models and serves them through an enterprise API on Baseten's multi-region inference infrastructure. This lets it meet real-time latency and uptime requirements and scale GPU capacity as customer demand grows.
Outros resultados informados
Números publicados no estudo de caso de Baseten. Eles não são medidos de forma independente pelo usedby.
Rime.ai offers a speech synthesis API with unmatched speed, lifelike accuracy, and support for over 200 distinct voices.
Nas palavras do cliente
It would be hard or impossible to get the GPUs we need right when we need them on the same terms that Baseten gives through any cloud service provider – this flexibility is essential as we scale.Outras ferramentas de IA usadas por Rime
Outras relações públicas registradas no usedby.
Explorar a stack de IA de Rime
Usuários de Baseten no setor Inteligência artificial
Empresas do mesmo setor, com evidências públicas.
 EliseAIConfirmado
 GammaConfirmado
 HebbiaConfirmado
 Oxen AIConfirmado
 Parallel Web SystemsConfirmado
 PoolsideConfirmado
Ir direto à fonte
Com base no estudo de caso publicado por Baseten. Verificamos as evidências públicas; os resultados são informados pelo fornecedor.
baseten.co- Fonte publicada em
- 23 de out. de 2024
- Última verificação
- 9 de out. de 2026
 Abrir a captura da fonte
O que o estudo de caso afirma e o que verificamos
O que comparamos com a página.
- O número: <300Verificado
O número está na página; o rótulo é redação nossa.
- O trecho citado acimaVerificado
Copiado palavra por palavra da página, perto do nome de Rime.
- A data de publicaçãoVerificado
Lida nos próprios metadados da página, nunca adivinhada.
- Rime usa BasetenVerificado
Linha de nível Confirmado.
- O resultado em siNão verificado
Nós o citamos; não o medimos.
Rime has consistently matched or beat their 300-millisecond p99 latency SLA for enterprise customers with optimized network serving and multi-region model deployments.