El uso: cómo HubSpot implementa Fivetran
HubSpot's People Operations team uses Fivetran to replace fragile DIY pipelines and spreadsheet imports, ingesting data from Workday, Greenhouse, Survey Monkey and FP&A spreadsheets into Snowflake. The centralized data supports workforce planning, hiring forecasts, eNPS analysis and generative AI initiatives on employee performance.
Otros resultados publicados
Cifras publicadas en el caso de estudio de Fivetran. usedby no las mide de forma independiente.
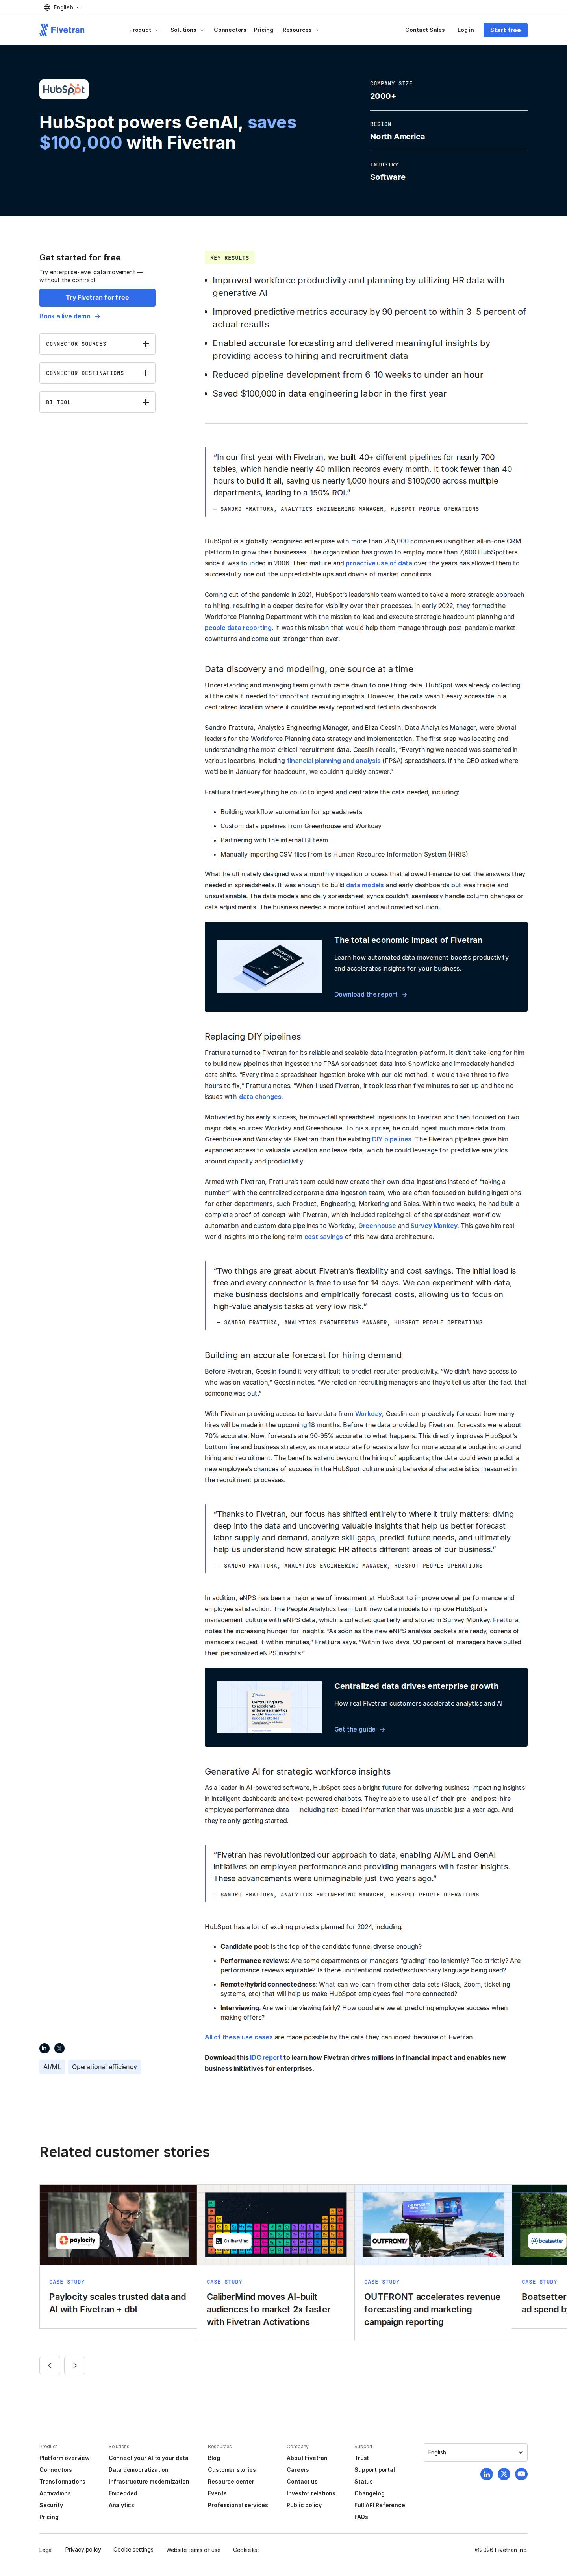
Reduced pipeline development from 6-10 weeks to under an hour
Now, forecasts are 90-95% accurate to what happens.
leading to a 150% ROI
Within two days, 90 percent of managers have pulled their personalized eNPS insights.
En palabras del cliente
In our first year with Fivetran, we built 40+ different pipelines for nearly 700 tables, which handle nearly 40 million records every month. It took fewer than 40 hours to build it all, saving us nearly 1,000 hours and $100,000 across multiple departments, leading to a 150% ROI.Otras herramientas de IA utilizadas por HubSpot
Otras relaciones públicas registradas en usedby.
Explorar las herramientas de IA de HubSpot
Otras empresas que utilizan Fivetran
Clientes de distintos sectores, con pruebas públicas.
 AxonConfirmado
 BoatsetterConfirmado
 BraunAbilityConfirmado
 CaliberMindConfirmado
 Inova HealthConfirmado
 LVMHConfirmado
Consultar la fuente
Basado en el caso de éxito publicado por Fivetran. Verificamos las pruebas públicas; los resultados son los que declara el proveedor.
fivetran.com- Última verificación
- 12 nov 2026
 Abrir la captura
Lo que dice la historia, y lo que verificamos
Lo que comparamos con la página.
- La cifra: $100,000Verificado
Impresa palabra por palabra en la página, cerca del nombre de HubSpot.
- El pasaje citado arribaVerificado
Copiado palabra por palabra de la página, cerca del nombre de HubSpot.
- HubSpot usa FivetranVerificado
Línea de nivel Confirmado.
- El resultado en síNo verificado
Lo citamos; no lo medimos.
In our first year with Fivetran, we built 40+ different pipelines for nearly 700 tables, which handle nearly 40 million records every month. It took fewer than 40 hours to build it all, saving us nearly 1,000 hours and $100,000