Cómo Multiply Labs utiliza Anyscale
Multiply Labs utiliza clústeres de Ray gestionados por Anyscale, desplegados en sus propias cuentas en la nube, para ejecutar el entrenamiento distribuido de modelos de IA de robótica empleados en la fabricación de productos biológicos. Ejecuta estas cargas de trabajo en AWS, GCP y Nebius para acceder a GPU de gama alta.
Ver la prueba capturadaEl uso: cómo Multiply Labs implementa Anyscale
Multiply Labs uses Anyscale-managed Ray clusters, deployed in its own cloud accounts, to run distributed training for robotics AI models used in biologics manufacturing. It runs these workloads across AWS, GCP and Nebius to get access to premium GPUs.
Cifras de la fuente
Cifras publicadas en el caso de estudio de Anyscale. usedby no las mide de forma independiente.
As a result, cluster spin-up with H100s on Nebius used for training was reduced from 30 to 10 minutes with similar results for other GPU types across cloud providers.
En palabras del cliente
Al usar Anyscale como gestor de clústeres de Ray multinube, hemos hecho que nuestras ejecuciones de entrenamiento sean totalmente portables entre hiperescaladores y proveedores de nube especializados, maximizando la disponibilidad de GPU.Traducción automática del inglésVer el original
Using Anyscale as our multi-cloud Ray cluster manager, we’ve made our training runs fully portable across hyperscalers and specialized cloud providers, maximizing GPU availability.Clientes de Anyscale en Biotecnología y farmacéutica
Empresas del mismo sector, con pruebas públicas.
Ver todos los clientes de Anyscale
Consultar la fuente
Basado en el caso de éxito publicado por Anyscale. Verificamos las pruebas públicas; los resultados son los que declara el proveedor.
anyscale.com- Última verificación
- 14 nov 2026
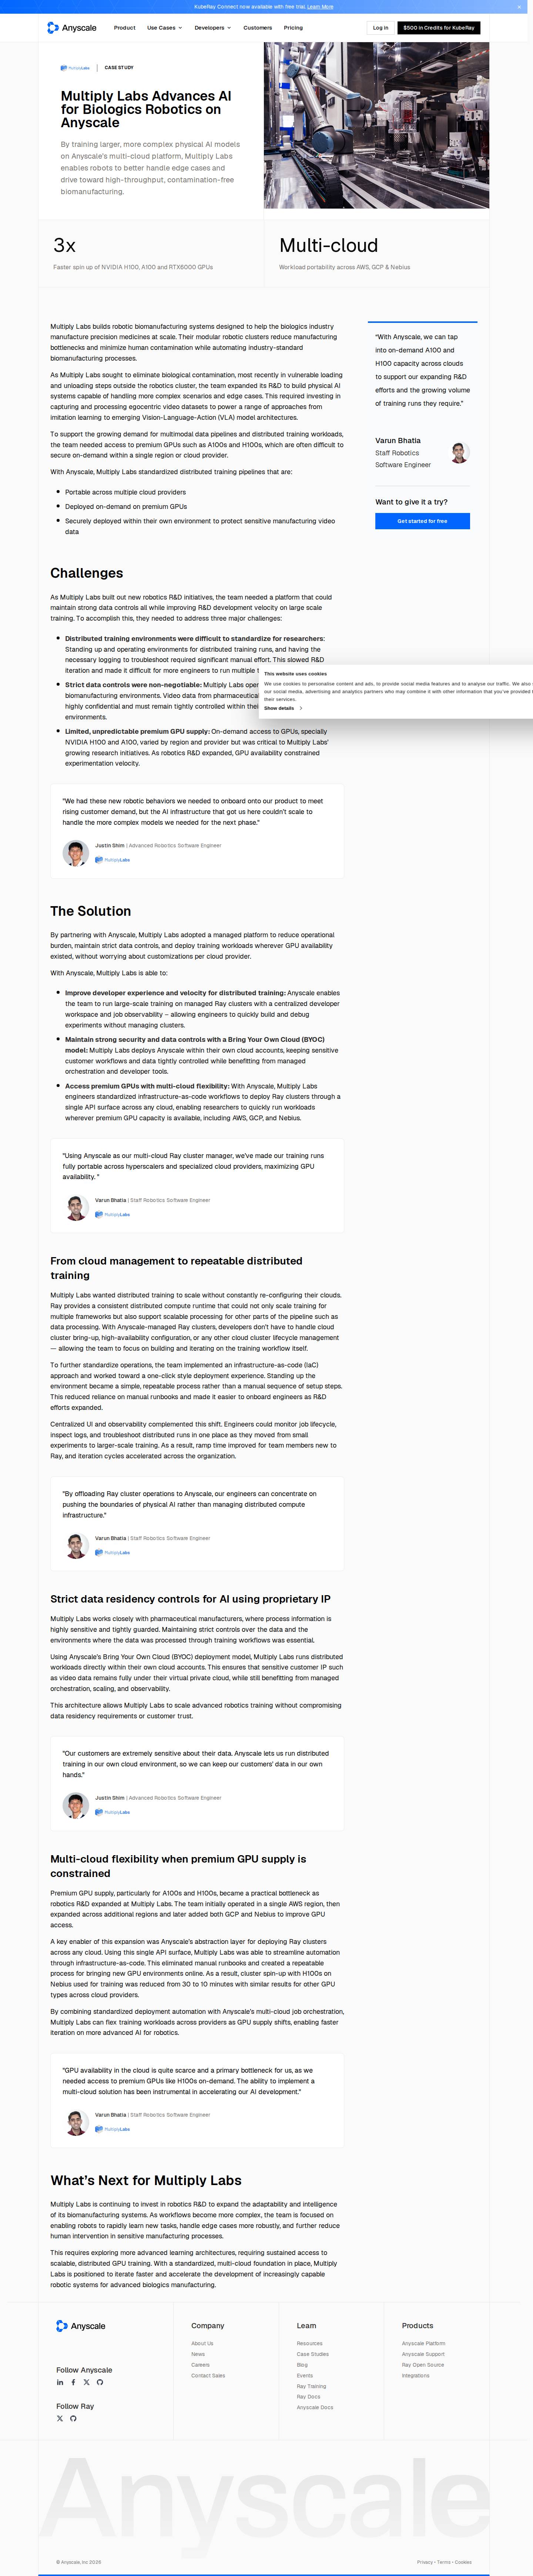 Abrir la captura
Lo que dice la historia, y lo que verificamos
Lo que comparamos con la página.
- El pasaje citado arribaVerificado
Copiado palabra por palabra de la página, cerca del nombre de Multiply Labs.
- Multiply Labs usa AnyscaleVerificado
Línea de nivel Confirmado.
- El resultado en síNo verificado
Lo citamos; no lo medimos.
As a result, cluster spin-up with H100s on Nebius used for training was reduced from 30 to 10 minutes with similar results for other GPU types across cloud providers.