L’usage : comment Cartesia déploie Together AI
Cartesia runs production real-time voice serving and model training on Together AI's GPU clusters. It operates a custom inference engine for its State Space Model architecture with cluster-level access, and uses PCI-compliant environments for regulated enterprise customers.
Le témoignage du client
Because our voice models use state space architectures, we need to run a purpose-built inference engine. Together AI gives us the compute and cluster-level access we need—down to the filesystem and SSH permissions—so we can optimize our serving stack exactly how we want. They manage the heavy lifting of the hardware orchestration and ingress, and we get the low-level control required to hit our streaming latency targets.Les autres outils IA utilisés par Cartesia
Autres relations publiques recensées sur usedby.
Explorer la stack IA de Cartesia
Les clients de Together AI dans le secteur Intelligence Artificielle
Des entreprises du même secteur, avec une preuve publique.
Voir tous les clients de Together AI
Consulter la source
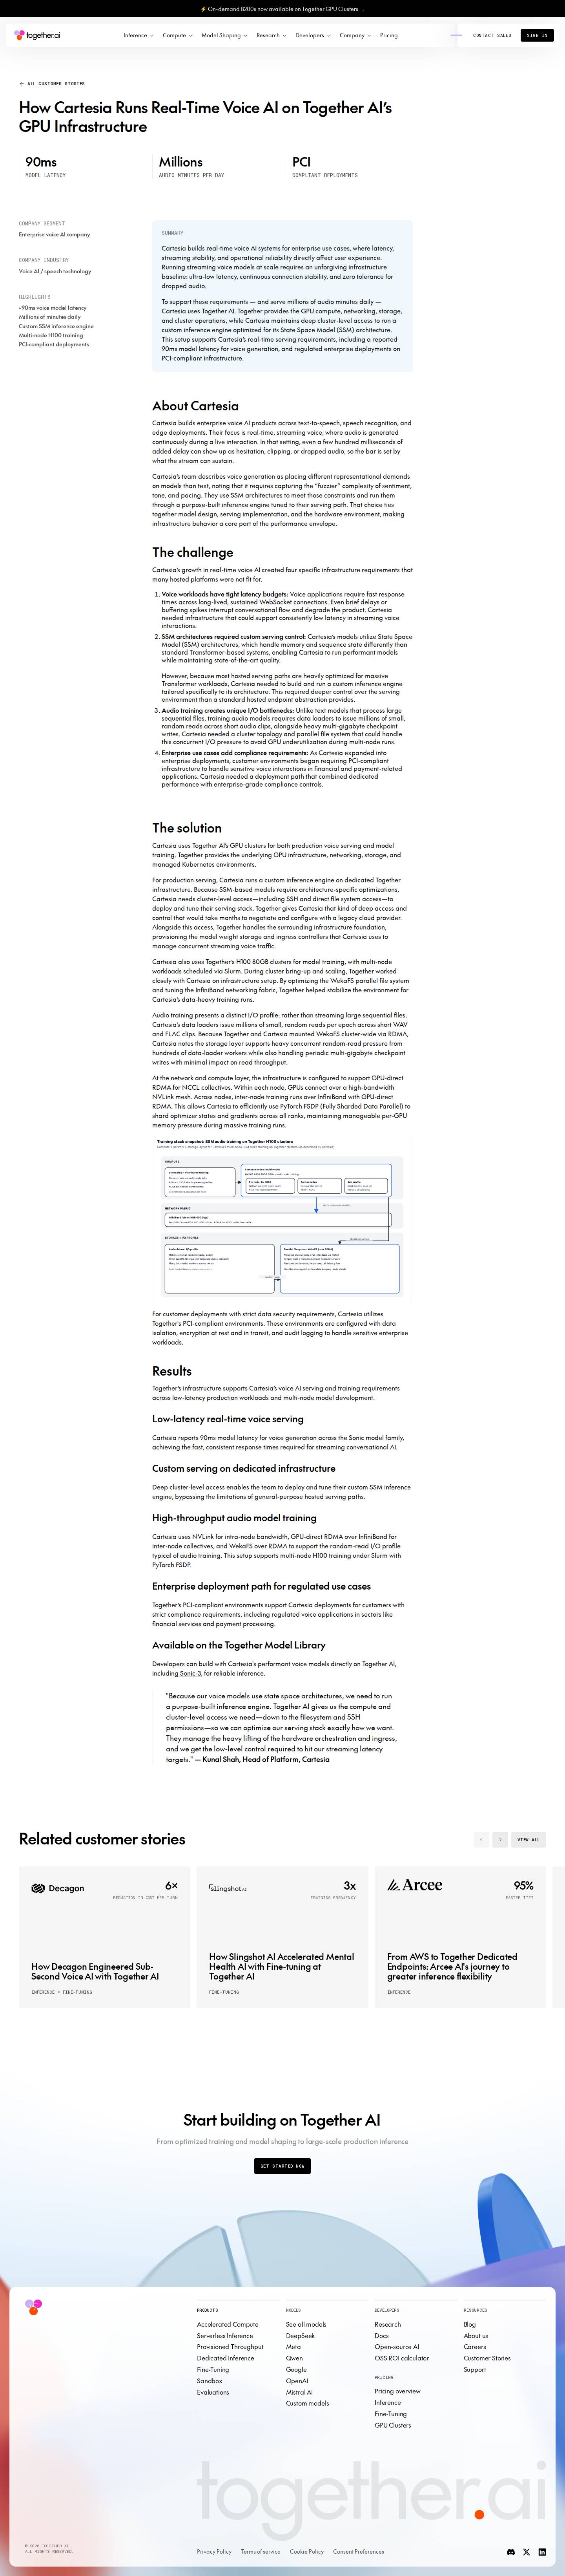
Cette synthèse repose sur l’étude de cas publiée par Together AI. Nous vérifions la preuve publique ; les résultats sont ceux rapportés par l’éditeur.
together.ai- Dernière vérification
- 3 oct. 2026
 Ouvrir la capture
Ce que dit le témoignage, et ce que nous avons vérifié
Ce que nous avons comparé à la page.
- L’extrait cité plus hautVérifié
Copié mot pour mot depuis la page, près du nom de Cartesia.
- Cartesia utilise Together AIVérifié
Ligne de niveau Confirmé.
- Le résultat lui-mêmeNon vérifié
Nous le citons ; nous ne l’avons pas mesuré.
Cartesia reports 90ms model latency for voice generation across the Sonic model family, achieving the fast, consistent response times required for streaming conversational AI.