Comment Lynx Analytics utilise Nebius AI Cloud
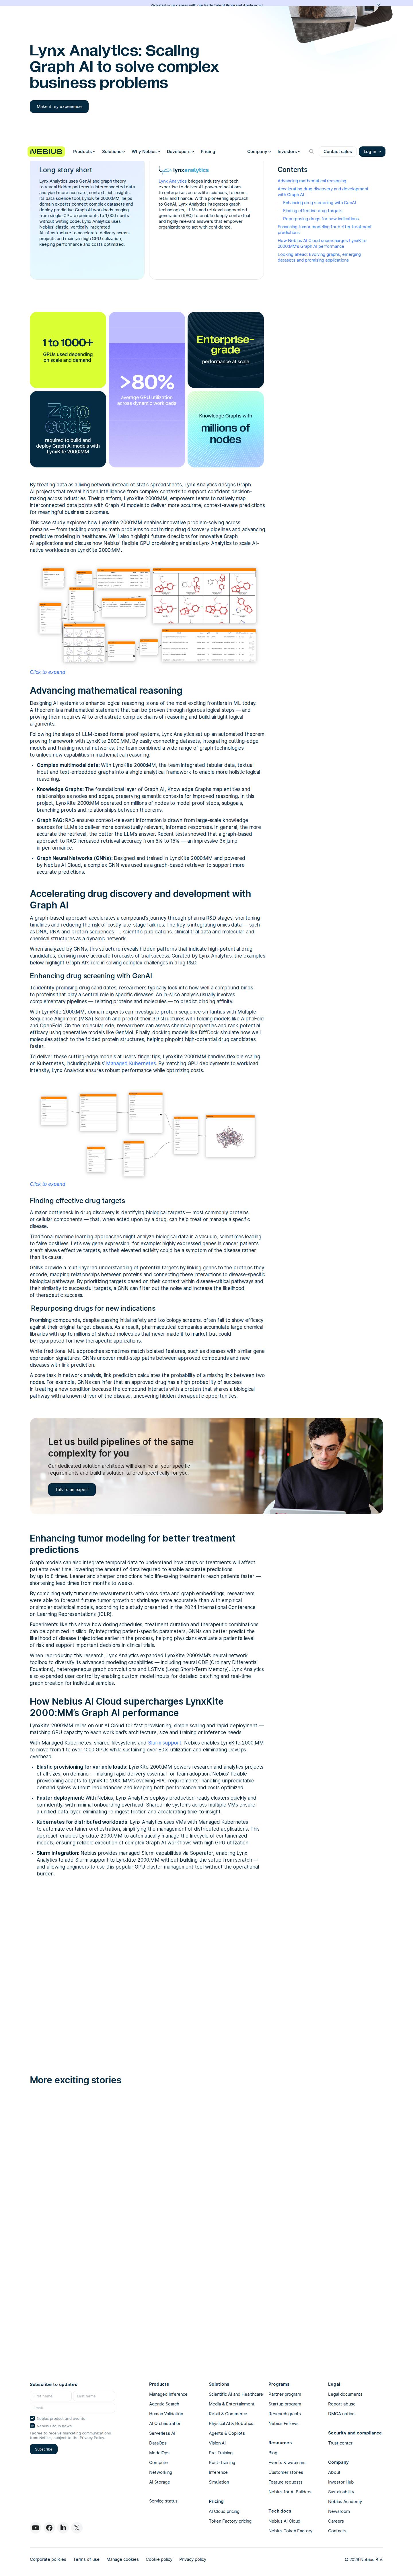
Lynx Analytics exécute sa plateforme de Graph AI, LynxKite 2000:MM, sur Nebius AI Cloud, en s'appuyant sur Managed Kubernetes, des systèmes de fichiers partagés et Slurm pour adapter la capacité GPU à chaque charge de travail. La plateforme prend en charge des projets tels que la démonstration automatique de théorèmes, la découverte de médicaments et la modélisation de tumeurs.
Voir la preuve capturéeL’usage : comment Lynx Analytics déploie Nebius AI Cloud
Lynx Analytics runs its Graph AI platform, LynxKite 2000:MM, on Nebius AI Cloud, using Managed Kubernetes, shared filesystems and Slurm to scale GPU capacity to each workload. The platform supports projects such as automated theorem proving, drug discovery and tumor modeling.
Les autres entreprises qui utilisent Nebius AI Cloud
Des clients de différents secteurs, avec une preuve publique.
Voir tous les clients de Nebius AI Cloud
Consulter la source
Cette synthèse repose sur l’étude de cas publiée par Nebius AI Cloud. Nous vérifions la preuve publique ; les résultats sont ceux rapportés par l’éditeur.
nebius.com- Dernière vérification
- 7 oct. 2026
 Ouvrir la capture
Ce que dit le témoignage, et ce que nous avons vérifié
Ce que nous avons comparé à la page.
- L’extrait cité plus hautVérifié
Copié mot pour mot depuis la page, près du nom de Lynx Analytics.
- Les nombres de notre résuméVérifié
Chacun est imprimé sur la page.
- Lynx Analytics utilise Nebius AI CloudVérifié
Ligne de niveau Confirmé.
- Le résultat lui-mêmeNon vérifié
Nous le citons ; nous ne l’avons pas mesuré.
With Managed Kubernetes, shared filesystems and Slurm support, Nebius enables LynxKite 2000:MM to move from 1 to over 1000 GPUs while sustaining over 80% utilization and eliminating DevOps overhead.