Comment Mem0 utilise turbopuffer
Mem0 fait tourner sa plateforme gérée de mémoire pour agents sur turbopuffer, avec un namespace dédié par client pour une recherche hybride vectorielle et plein texte avec filtrage par attributs. Les embeddings ont été migrés depuis pgvector dans Postgres, qui peinait à tenir la latence à grande échelle.
Voir la preuve capturéeL’usage : comment Mem0 déploie turbopuffer
Mem0 runs its managed agent memory platform on turbopuffer, giving each customer a dedicated namespace for hybrid vector and full-text search with attribute filtering. Embeddings were migrated off pgvector in Postgres, which struggled with latency at scale.
Autres résultats publiés
Chiffres publiés dans l’étude de cas de turbopuffer. usedby ne les mesure pas de façon indépendante.
97% average vector recall@10
70ms p90 hybrid retrieval latency on turbopuffer
150k+ customers, each with an isolated search index
Scaled from 100M → 400M+ memories without latency increase or recall drop
Le témoignage du client
Le principal avantage de turbopuffer, c'est la tranquillité d'esprit : nous savons que nous ne flancherons pas en montant en charge.Traduction automatique de l’anglaisVoir l’original
The biggest benefit of turbopuffer is the peace of mind that we won't fall over as we scale.Les autres entreprises qui utilisent turbopuffer
Des clients de différents secteurs, avec une preuve publique.
Voir tous les clients de turbopuffer
Consulter la source
Cette synthèse repose sur l’étude de cas publiée par turbopuffer. Nous vérifions la preuve publique ; les résultats sont ceux rapportés par l’éditeur.
turbopuffer.com- Dernière vérification
- 12 nov. 2026
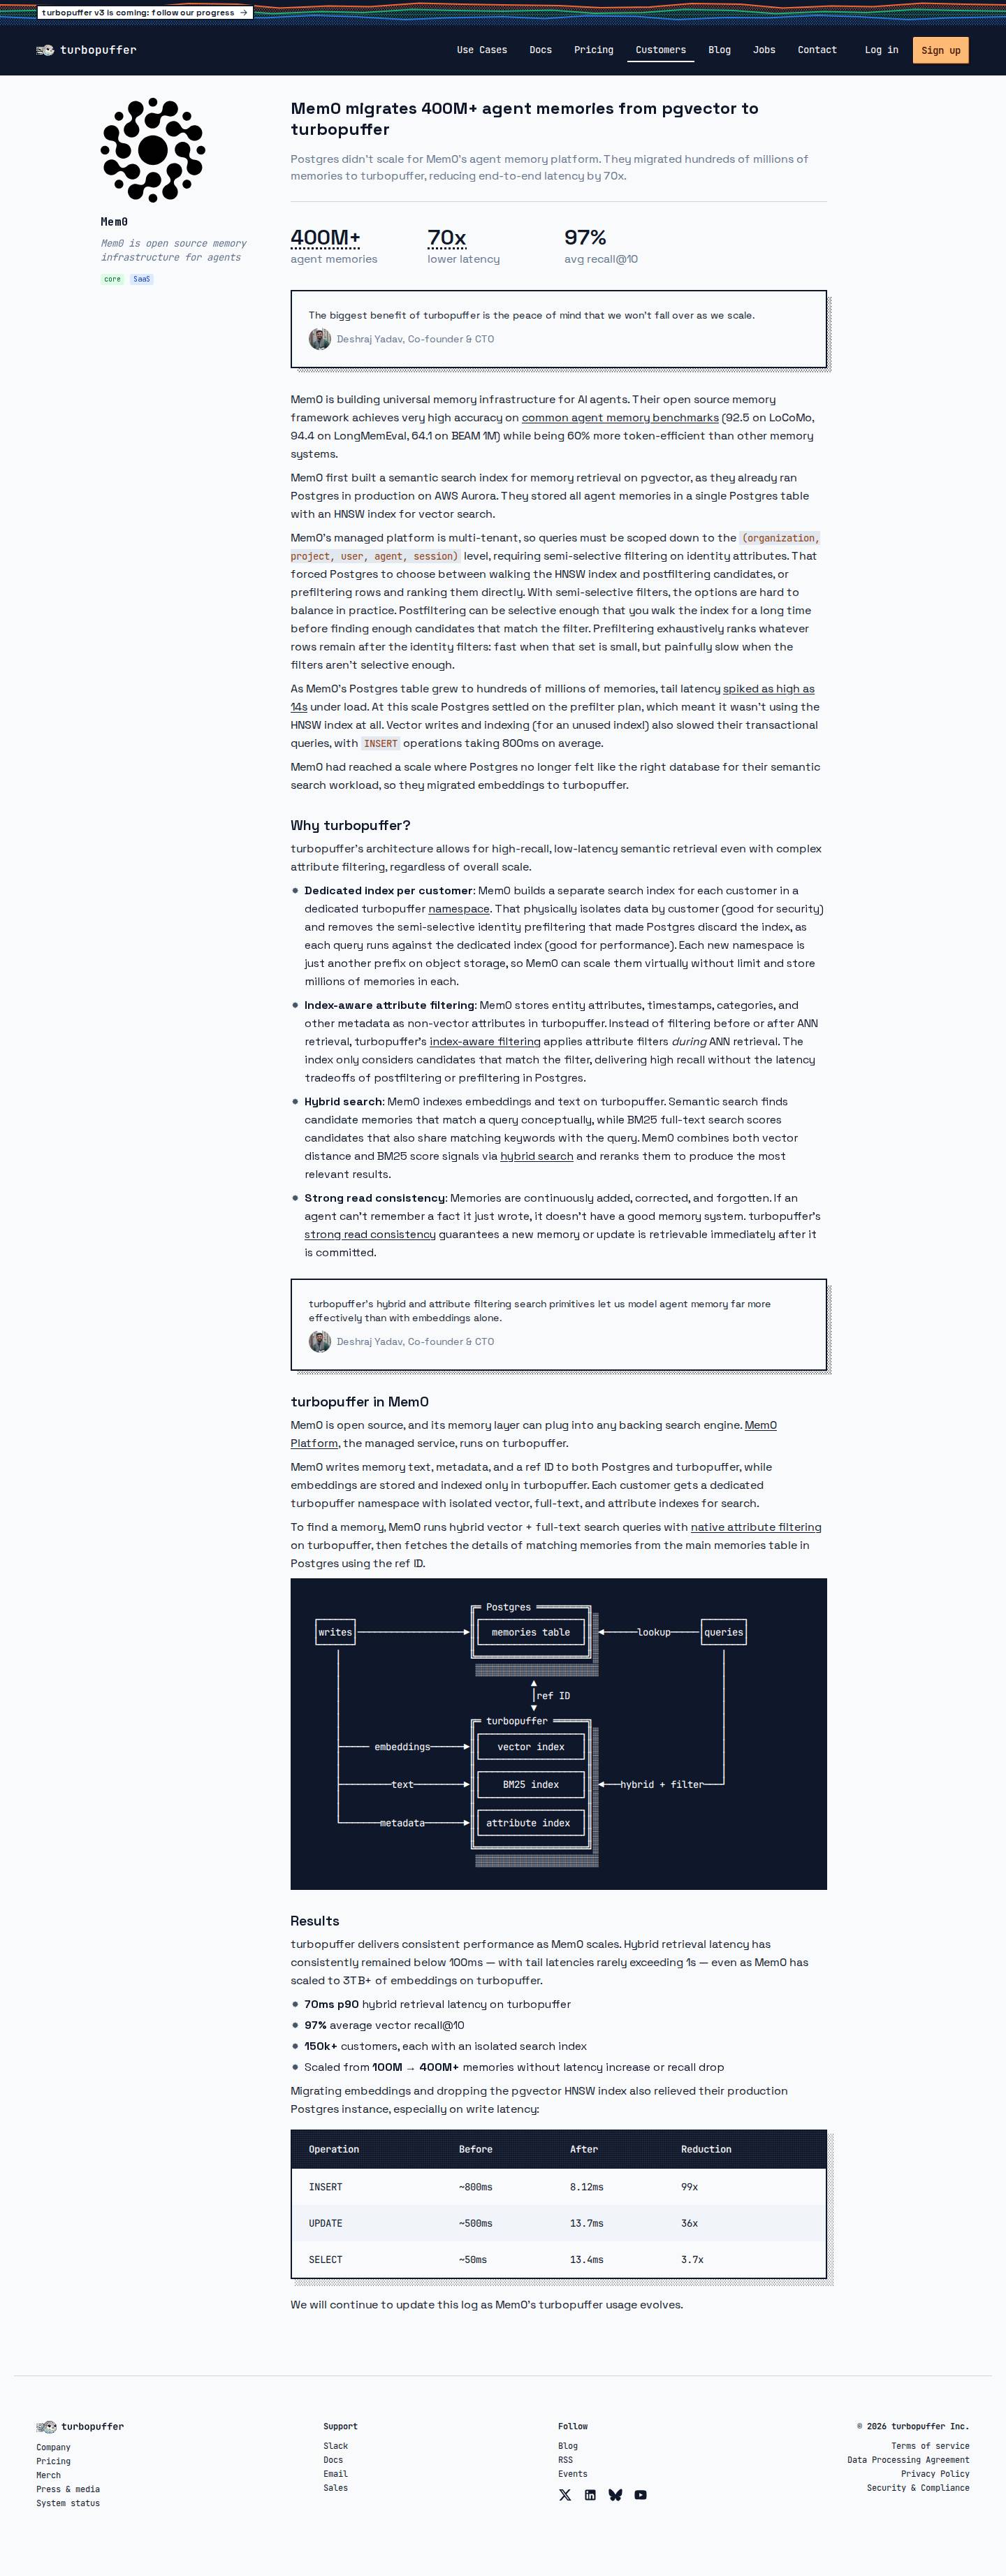 Ouvrir la capture
Ce que dit le témoignage, et ce que nous avons vérifié
Ce que nous avons comparé à la page.
- Le chiffre : 70xVérifié
Imprimé mot pour mot sur la page, près du nom de Mem0.
- L’extrait cité plus hautVérifié
Copié mot pour mot depuis la page, près du nom de Mem0.
- Mem0 utilise turbopufferVérifié
Ligne de niveau Confirmé.
- Le résultat lui-mêmeNon vérifié
Nous le citons ; nous ne l’avons pas mesuré.
Hybrid retrieval latency has consistently remained below 100ms — with tail latencies rarely exceeding 1s — even as Mem0 has scaled to 3TB+ of embeddings on turbopuffer.