O caso de uso: como Decagon implanta Together AI
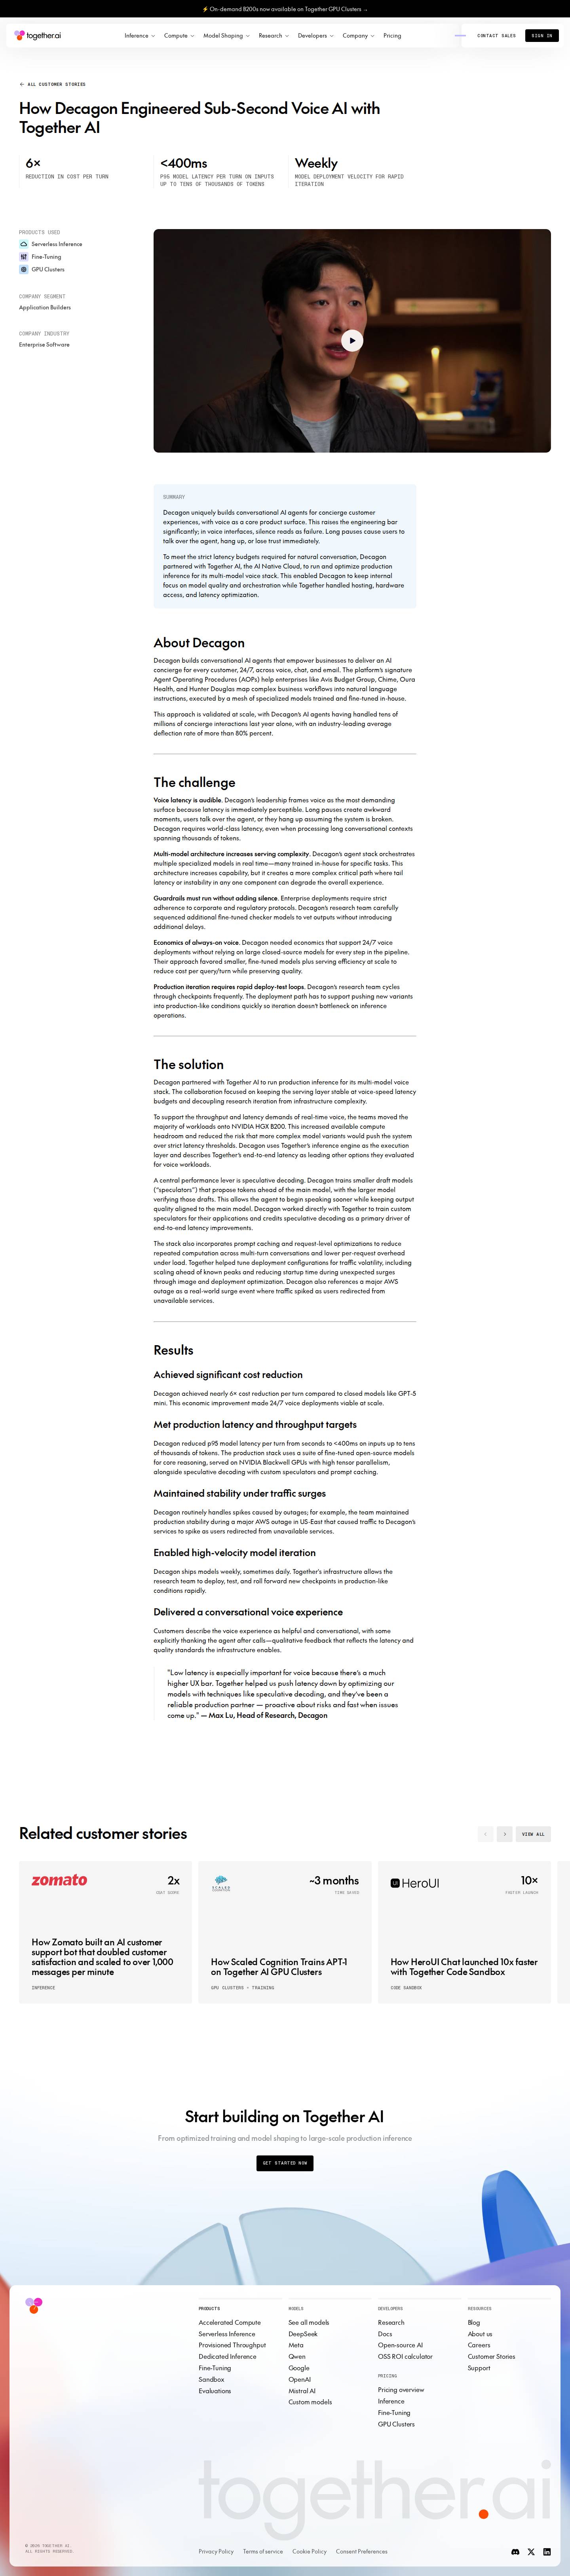
Decagon runs production inference for its multi-model voice AI agents on Together AI, using hosted open-source and fine-tuned models on NVIDIA B200 GPUs. Together also helped train custom speculative decoding draft models and tune deployments to meet strict latency budgets.
Outros resultados informados
Números publicados no estudo de caso de Together AI. Eles não são medidos de forma independente pelo usedby.
Decagon reduced p95 model latency per turn from seconds to <400ms on inputs up to tens of thousands of tokens.
Nas palavras do cliente
Low latency is especially important for voice because there’s a much higher UX bar. Together helped us push latency down by optimizing our models with techniques like speculative decoding, and they’ve been a reliable production partner — proactive about risks and fast when issues come up.Outras ferramentas de IA usadas por Decagon
Outras relações públicas registradas no usedby.
Explorar a stack de IA de Decagon
Usuários de Together AI no setor Inteligência artificial
Empresas do mesmo setor, com evidências públicas.
 Arcee AIConfirmado
 CartesiaConfirmado
 Deep CogitoConfirmado
 Dippy AIConfirmado
 HedraConfirmado
 LegionEdgeConfirmado
Ir direto à fonte
Com base no estudo de caso publicado por Together AI. Verificamos as evidências públicas; os resultados são informados pelo fornecedor.
together.ai- Última verificação
- 3 de out. de 2026
 Abrir a captura da fonte
O que o estudo de caso afirma e o que verificamos
O que comparamos com a página.
- O número: 6×Verificado
Impresso palavra por palavra na página, perto do nome de Decagon.
- O trecho citado acimaVerificado
Copiado palavra por palavra da página, perto do nome de Decagon.
- Decagon usa Together AIVerificado
Linha de nível Confirmado.
- O resultado em siNão verificado
Nós o citamos; não o medimos.
Decagon achieved nearly 6× cost reduction per turn compared to closed models like GPT-5 mini. This economic improvement made 24/7 voice deployments viable at scale.