Como Wispr Flow usa Baseten
A Wispr Flow executa modelos Llama com ajuste fino para a limpeza de transcrições em tempo real em implantações dedicadas da Baseten, hospedadas na AWS. Os modelos e o pipeline de reconhecimento de fala alimentam o ditado por voz em diversos aplicativos, usando o construtor de engines TensorRT-LLM, o framework Chains e as GPUs com escalonamento automático da Baseten.
Ver a prova capturadaO caso de uso: como Wispr Flow implanta Baseten
Wispr Flow runs fine-tuned Llama models for real-time transcript cleanup on Baseten's dedicated deployments, hosted on AWS. The models and its speech recognition pipeline power voice dictation across applications, using Baseten's TensorRT-LLM engine builder, Chains framework and autoscaling GPUs.
Outros resultados informados
Números publicados no estudo de caso de Baseten. Eles não são medidos de forma independente pelo usedby.
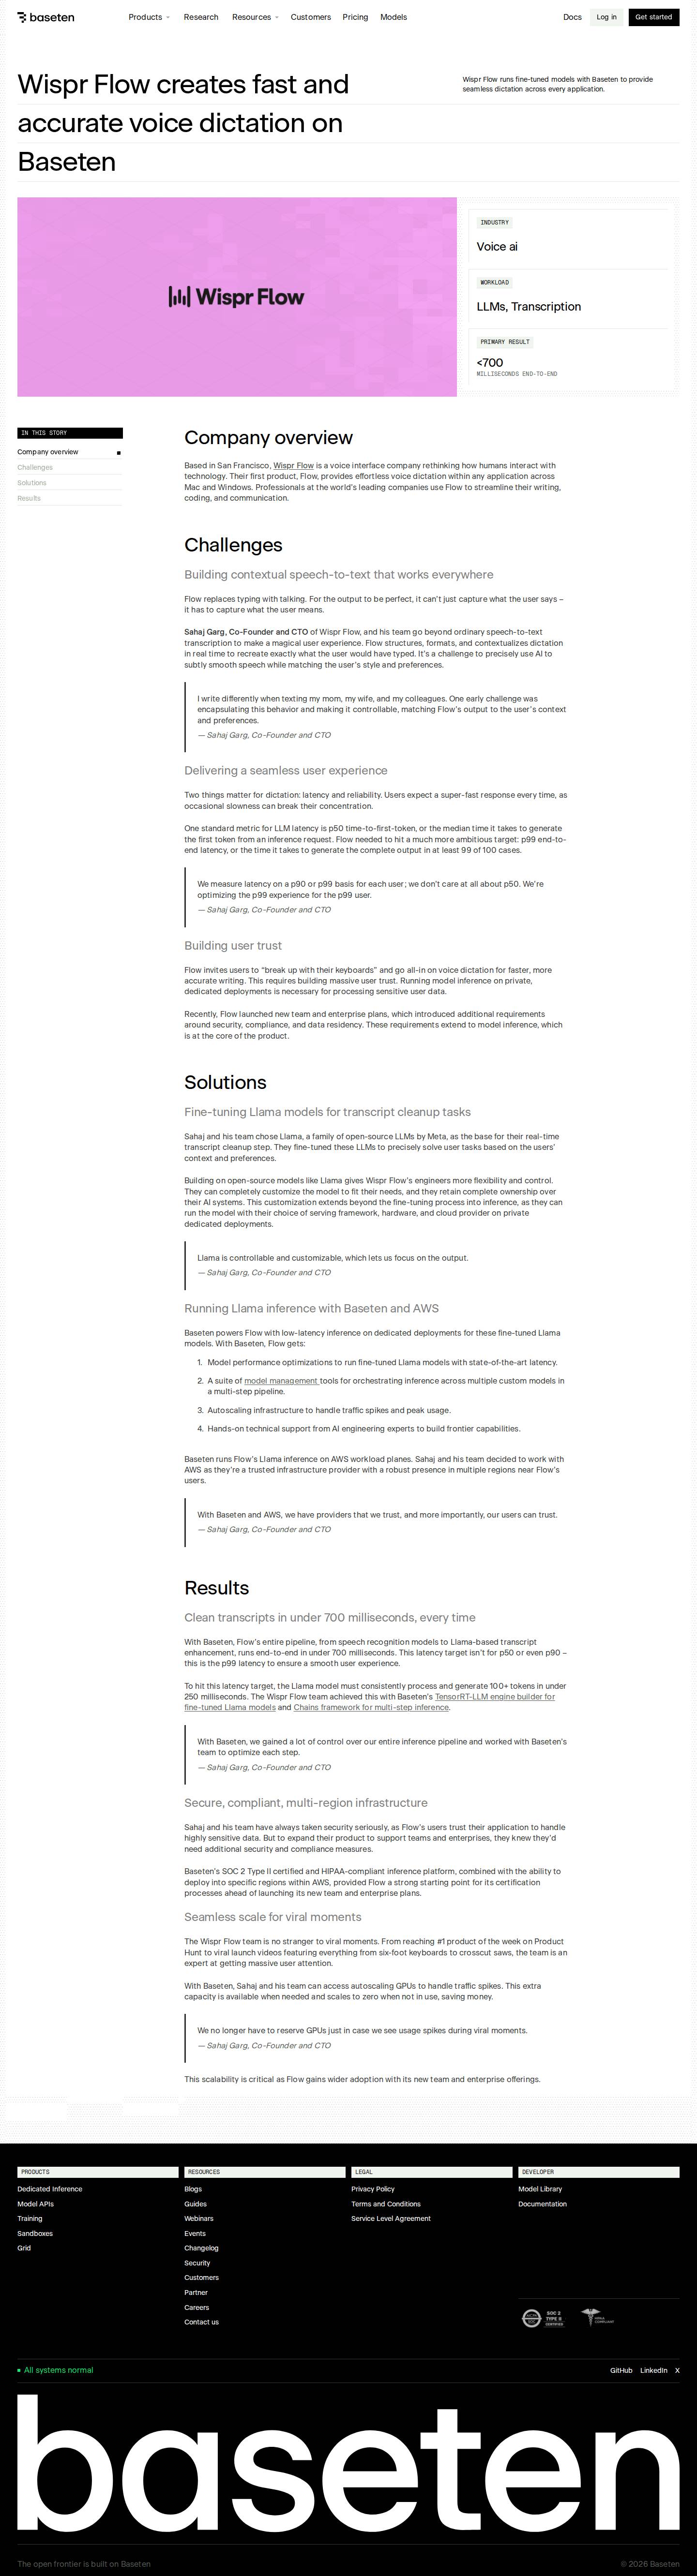
To hit this latency target, the Llama model must consistently process and generate 100+ tokens in under 250 milliseconds.
Nas palavras do cliente
Com a Baseten, ganhamos muito controle sobre todo o nosso pipeline de inferência e trabalhamos com a equipe da Baseten para otimizar cada etapa.Tradução automática do inglêsVer o original
With Baseten, we gained a lot of control over our entire inference pipeline and worked with Baseten’s team to optimize each step.Outras ferramentas de IA usadas por Wispr Flow
Outras relações públicas registradas no usedby.
Explorar a stack de IA de Wispr Flow
Usuários de Baseten no setor Inteligência artificial
Empresas do mesmo setor, com evidências públicas.
 EliseAIConfirmado
 GammaConfirmado
 HebbiaConfirmado
 Oxen AIConfirmado
 Parallel Web SystemsConfirmado
 PoolsideConfirmado
Ir direto à fonte
Com base no estudo de caso publicado por Baseten. Verificamos as evidências públicas; os resultados são informados pelo fornecedor.
baseten.co- Última verificação
- 11 de nov. de 2026
 Abrir a captura da fonte
O que o estudo de caso afirma e o que verificamos
O que comparamos com a página.
- O número: 700 millisecondsVerificado
Impresso palavra por palavra na página, perto do nome de Wispr Flow.
- O trecho citado acimaVerificado
Copiado palavra por palavra da página, perto do nome de Wispr Flow.
- Wispr Flow usa BasetenVerificado
Linha de nível Confirmado.
- O resultado em siNão verificado
Nós o citamos; não o medimos.
With Baseten, Flow’s entire pipeline, from speech recognition models to Llama-based transcript enhancement, runs end-to-end in under 700 milliseconds. This latency target isn’t for p50 or even p90 – this is the p99 latency to ensure a smooth user experience.