Wie Wispr Flow Baseten nutzt
Wispr Flow betreibt feinabgestimmte Llama-Modelle für die Bereinigung von Transkripten in Echtzeit auf den dedizierten Deployments von Baseten, die auf AWS gehostet werden. Die Modelle und die zugehörige Spracherkennungs-Pipeline ermöglichen Diktieren per Sprache in verschiedenen Anwendungen und nutzen dafür den TensorRT-LLM-Engine-Builder, das Chains-Framework und automatisch skalierende GPUs von Baseten.
Erfassten Nachweis ansehenDer Anwendungsfall: wie Wispr Flow Baseten einsetzt
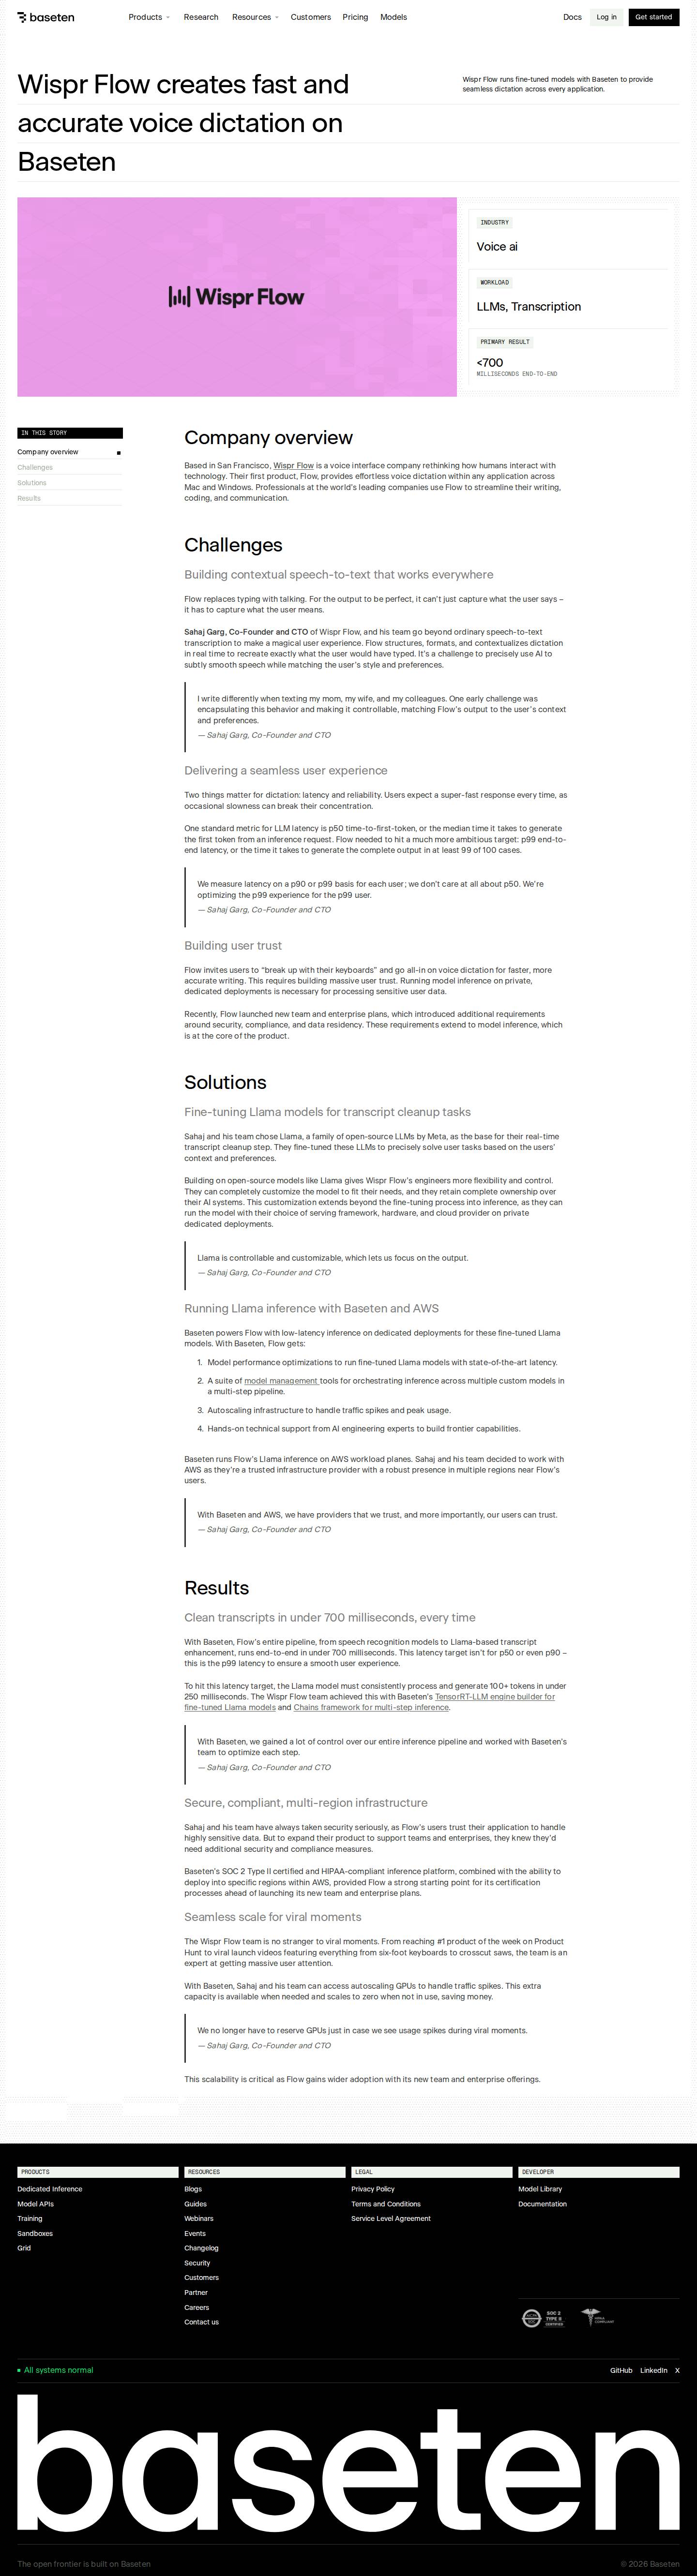
Wispr Flow runs fine-tuned Llama models for real-time transcript cleanup on Baseten's dedicated deployments, hosted on AWS. The models and its speech recognition pipeline power voice dictation across applications, using Baseten's TensorRT-LLM engine builder, Chains framework and autoscaling GPUs.
Weitere angegebene Ergebnisse
Zahlen aus der Fallstudie von Baseten. usedby hat sie nicht unabhängig gemessen.
To hit this latency target, the Llama model must consistently process and generate 100+ tokens in under 250 milliseconds.
In den Worten des Kunden
Mit Baseten haben wir viel mehr Kontrolle über unsere gesamte Inferenz-Pipeline gewonnen und gemeinsam mit dem Team von Baseten jeden einzelnen Schritt optimiert.Maschinell übersetzt aus dem EnglischenOriginal anzeigen
With Baseten, we gained a lot of control over our entire inference pipeline and worked with Baseten’s team to optimize each step.Weitere KI-Tools von Wispr Flow
Weitere öffentliche Beziehungen, die auf usedby erfasst sind.
Den KI-Stack von Wispr Flow ansehen
Nutzer von Baseten in der Branche Künstliche Intelligenz
Unternehmen derselben Branche, mit öffentlichen Belegen.
 EliseAIBestätigt
 GammaBestätigt
 HebbiaBestätigt
 Oxen AIBestätigt
 Parallel Web SystemsBestätigt
 PoolsideBestätigt
Direkt zur Quelle
Auf Basis der veröffentlichten Fallstudie von Baseten. Wir prüfen die öffentlichen Belege; die Ergebnisse gibt der Anbieter an.
baseten.co- Zuletzt geprüft
- 11. Nov. 2026
 Screenshot der Quelle öffnen
Was die Fallstudie behauptet und was wir geprüft haben
Was wir mit der Seite verglichen haben.
- Die Zahl: 700 millisecondsGeprüft
Steht wörtlich auf der Seite, nahe dem Namen Wispr Flow.
- Die oben zitierte PassageGeprüft
Wörtlich von der Seite übernommen, nahe dem Namen Wispr Flow.
- Wispr Flow nutzt BasetenGeprüft
Eintrag mit Stufe Bestätigt.
- Das Ergebnis selbstNicht geprüft
Wir zitieren es; wir haben es nicht gemessen.
With Baseten, Flow’s entire pipeline, from speech recognition models to Llama-based transcript enhancement, runs end-to-end in under 700 milliseconds. This latency target isn’t for p50 or even p90 – this is the p99 latency to ensure a smooth user experience.