El uso: cómo Inova Health implementa Fivetran
Inova Health uses Fivetran as the standard data movement layer to replace fragmented pipelines and unify data from on-prem systems, Epic, APIs and vendor platforms into a Databricks and dbt architecture. It also uses the Connector SDK for custom sources and Hybrid Deployment for tightly controlled environments, supporting analytics and AI initiatives.
Otros resultados publicados
Cifras publicadas en el caso de estudio de Fivetran. usedby no las mide de forma independiente.
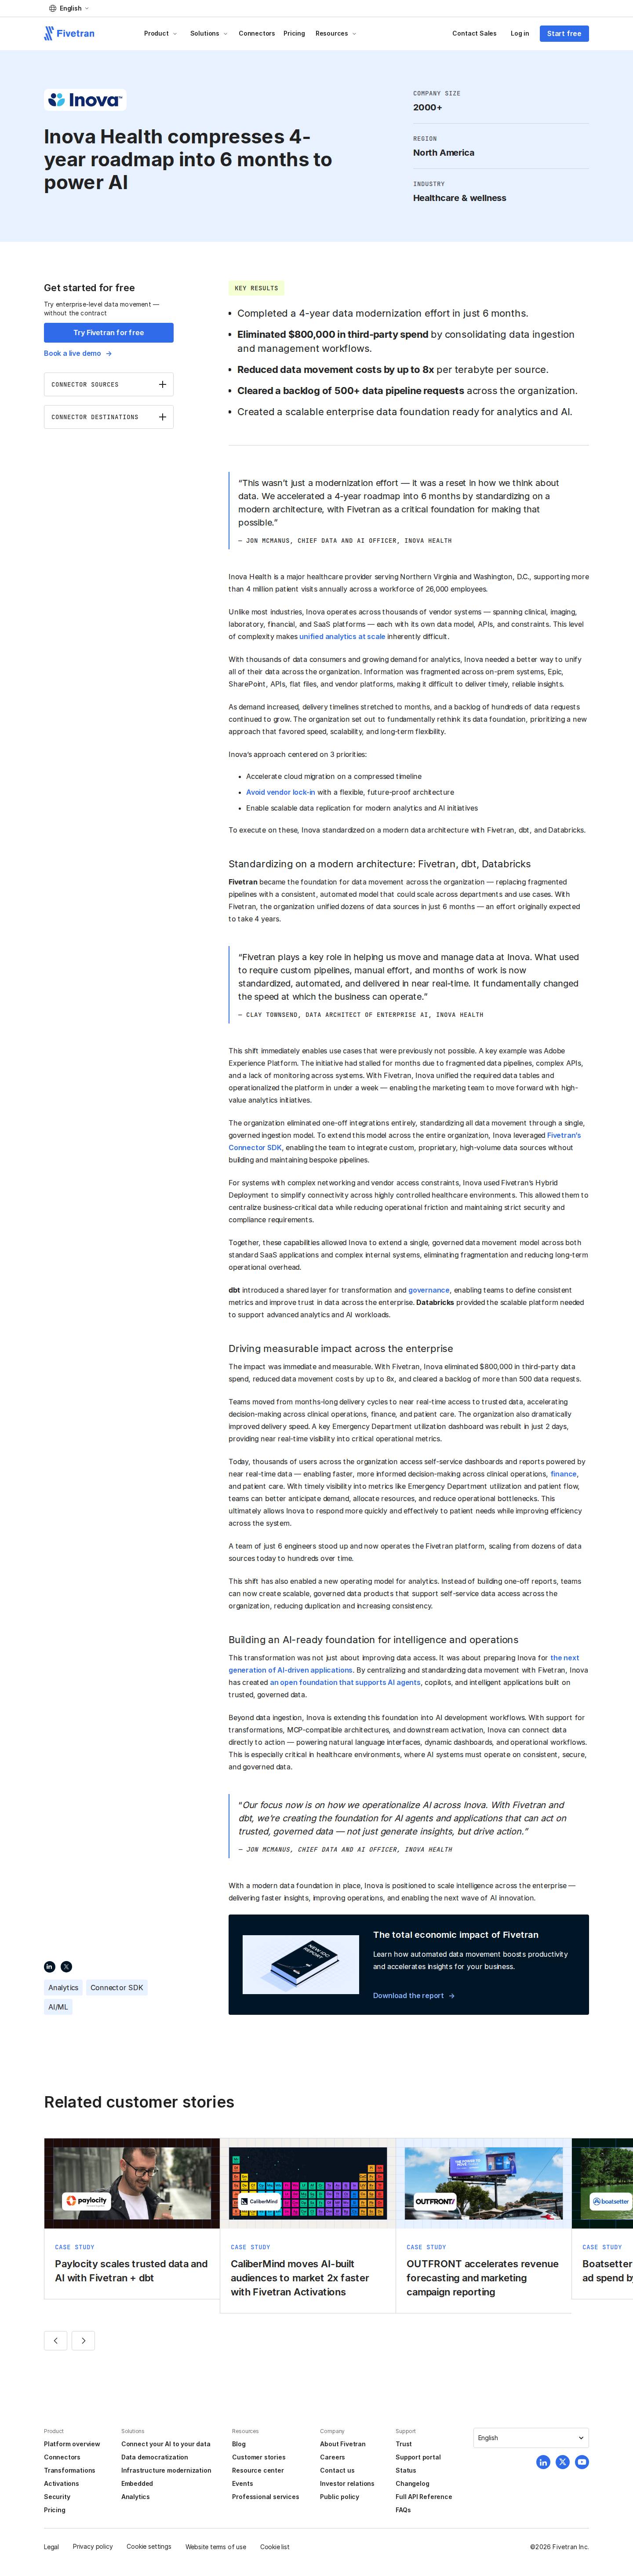
Eliminated $800,000 in third-party spend by consolidating data ingestion and management workflows.
Reduced data movement costs by up to 8x per terabyte per source.
Cleared a backlog of 500+ data pipeline requests across the organization.
A key Emergency Department utilization dashboard was rebuilt in just 2 days, providing near real-time visibility into critical operational metrics.
En palabras del cliente
This wasn’t just a modernization effort — it was a reset in how we think about data. We accelerated a 4-year roadmap into 6 months by standardizing on a modern architecture, with Fivetran as a critical foundation for making that possible.Otras empresas que utilizan Fivetran
Clientes de distintos sectores, con pruebas públicas.
 AxonConfirmado
 BoatsetterConfirmado
 BraunAbilityConfirmado
 CaliberMindConfirmado
 HubSpotConfirmado
 LVMHConfirmado
Consultar la fuente
Basado en el caso de éxito publicado por Fivetran. Verificamos las pruebas públicas; los resultados son los que declara el proveedor.
fivetran.com- Última verificación
- 12 nov 2026
 Abrir la captura
Lo que dice la historia, y lo que verificamos
Lo que comparamos con la página.
- La cifra: 6 monthsVerificado
Impresa palabra por palabra en la página, cerca del nombre de Inova Health.
- El pasaje citado arribaVerificado
Copiado palabra por palabra de la página, cerca del nombre de Inova Health.
- Inova Health usa FivetranVerificado
Línea de nivel Confirmado.
- El resultado en síNo verificado
Lo citamos; no lo medimos.
With Fivetran, the organization unified dozens of data sources in just 6 months — an effort originally expected to take 4 years.