Cómo NAB utiliza Fivetran
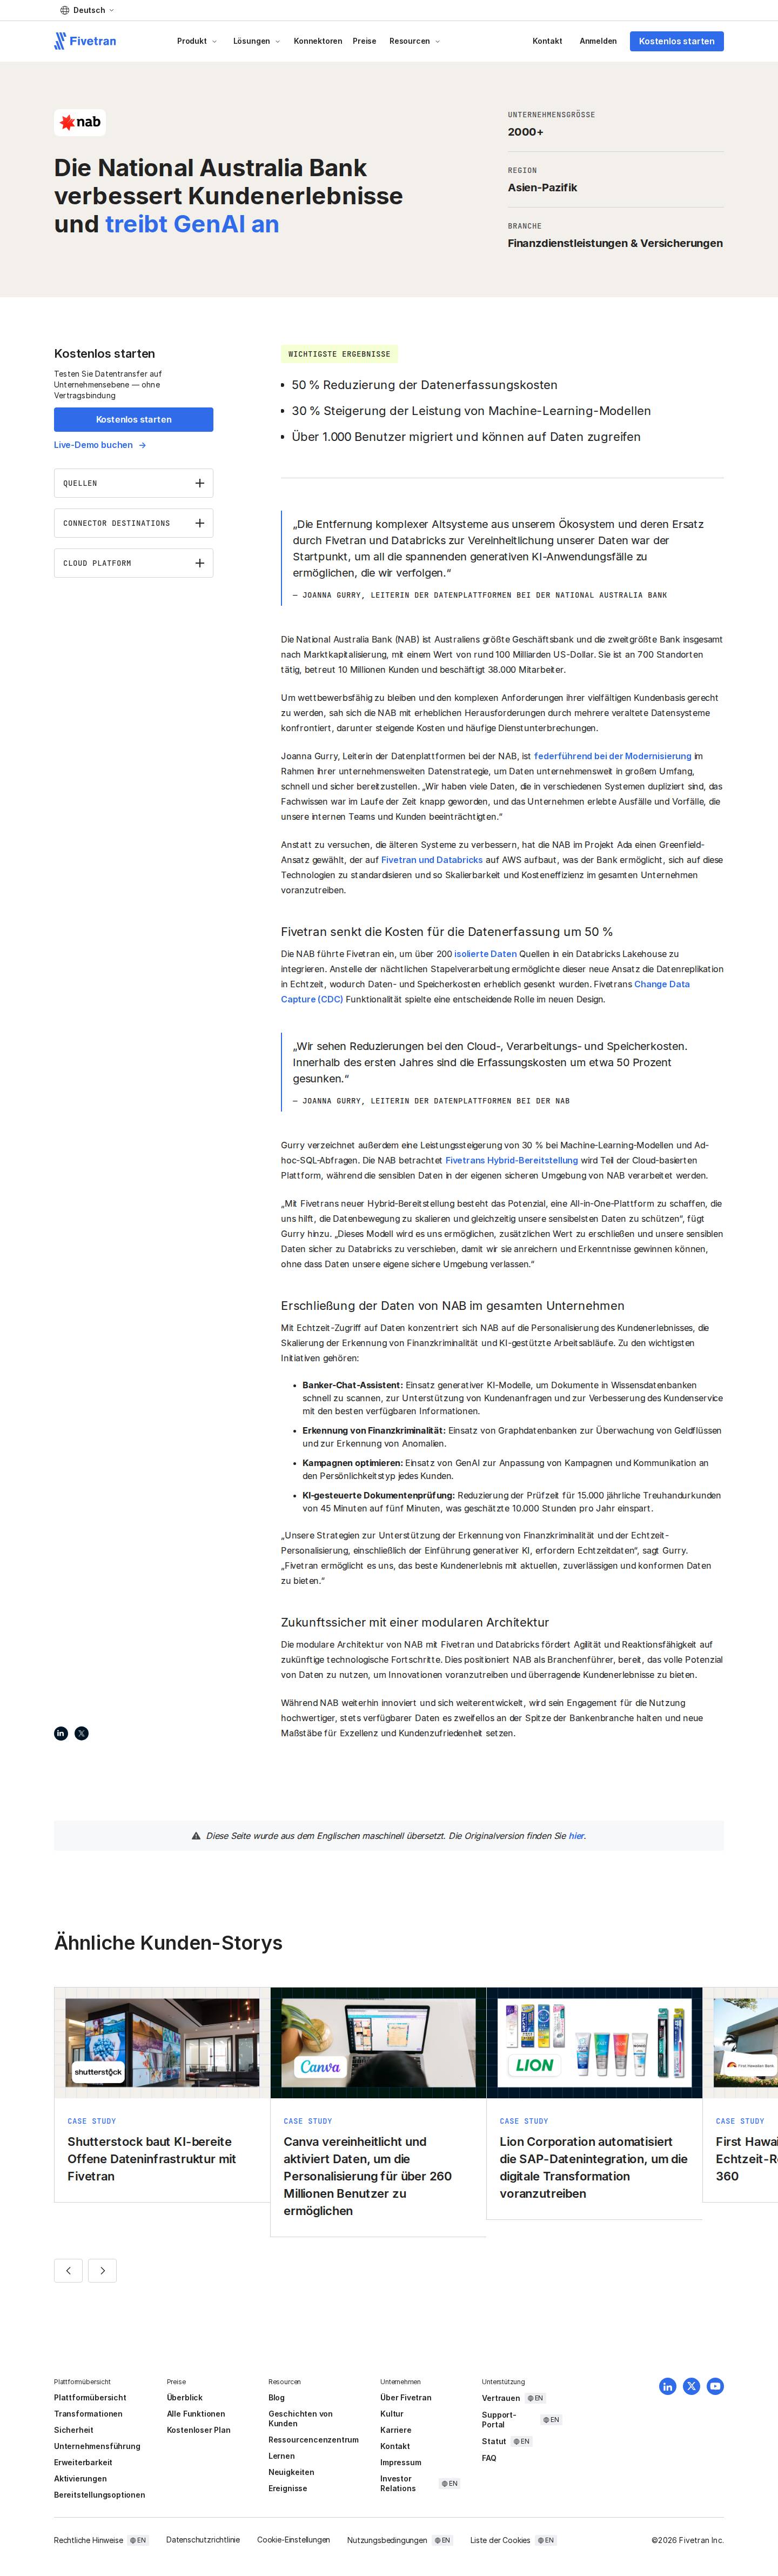
NAB usa Fivetran para integrar más de 200 fuentes de datos aisladas en un lakehouse de Databricks en AWS, en sustitución del procesamiento por lotes nocturno con replicación en tiempo real mediante captura de datos de cambios. Los datos respaldan iniciativas de IA generativa, detección de delitos financieros y personalización para los clientes.
Ver la prueba capturadaEl uso: cómo NAB implementa Fivetran
NAB uses Fivetran to integrate over 200 siloed data sources into a Databricks lakehouse on AWS, replacing nightly batch processing with real-time replication via change data capture. The data supports generative AI, financial crime detection and customer personalization initiatives.
Otros resultados publicados
Cifras publicadas en el caso de estudio de Fivetran. usedby no las mide de forma independiente.
Gurry verzeichnet außerdem eine Leistungssteigerung von 30 % bei Machine-Learning-Modellen und Ad-hoc-SQL-Abfragen.
Über 1.000 Benutzer migriert und können auf Daten zugreifen
En palabras del cliente
Removing complex legacy technology from our ecosystem and replacing it with Fivetran and Databricks to unify our data has been the springboard to enable all of the exciting generative AI use cases we are pursuing.Otras herramientas de IA utilizadas por NAB
Otras relaciones públicas registradas en usedby.
Explorar las herramientas de IA de NAB
Clientes de Fivetran en Banca y crédito
Empresas del mismo sector, con pruebas públicas.
Ver todos los clientes de Fivetran
Consultar la fuente
Basado en el caso de éxito publicado por Fivetran. Verificamos las pruebas públicas; los resultados son los que declara el proveedor.
fivetran.com- Última verificación
- 12 nov 2026
 Abrir la captura
Lo que dice la historia, y lo que verificamos
Lo que comparamos con la página.
- Los números de nuestro resumenVerificado
Cada uno está impreso en la página.
- NAB usa FivetranVerificado
Línea de nivel Confirmado.
- El resultado en síNo verificado
Lo citamos; no lo medimos.
Die NAB führte Fivetran ein, um über 200 isolierte Daten Quellen in ein Databricks Lakehouse zu integrieren. Anstelle der nächtlichen Stapelverarbeitung ermöglichte dieser neue Ansatz die Datenreplikation in Echtzeit, wodurch Daten- und Speicherkosten erheblich gesenkt wurden.