Comment Coactive utilise Anyscale
Coactive AI exécute sa plateforme d'IA multimodale d'analyse d'images et de vidéos sur Anyscale, avec Ray Serve dans une configuration Bring Your Own Cloud sur ses clusters Kubernetes répartis entre AWS et Azure. Elle utilise l'allocation fractionnée de GPU et l'autoscaling pour servir des recherches à faible latence et des traitements par lots de grande ampleur.
Voir la preuve capturéeL’usage : comment Coactive déploie Anyscale
Coactive AI runs its multimodal AI platform for image and video analysis on Anyscale, using Ray Serve in a Bring Your Own Cloud setup on its Kubernetes clusters across AWS and Azure. It uses fractional GPU allocation and autoscaling to serve low-latency search and large batch processing workloads.
Autres résultats publiés
Chiffres publiés dans l’étude de cas de Anyscale. usedby ne les mesure pas de façon indépendante.
driving a 75% reduction in GPU spend and a 4x drop in per-image processing cost.
1 day to deploy new multimodal model endpoints, down from 1+ week
With Anyscale, service definitions shrank to roughly 25% of their previous code size, which enabled more developers to safely modify and deploy Ray Serve endpoints.
Le témoignage du client
L'un de nos ingénieurs en IA appliquée a dit : « on devrait utiliser ce modèle », et le lendemain il tournait en production. Avant Anyscale, cela aurait pris une semaine ou plus.Traduction automatique de l’anglaisVoir l’original
One of our applied AI engineers said, ‘we should use this model,’ and the next day it was running in production. Before Anyscale, that would’ve taken a week or more.Les clients de Anyscale dans le secteur Intelligence artificielle
Des entreprises du même secteur, avec une preuve publique.
 Bedrock RoboticsConfirmé
 Physical IntelligenceConfirmé
 RunwayConfirmé
 Character.aiObservé
 ReflectionObservé
 Torc RoboticsObservé
Consulter la source
Cette synthèse repose sur l’étude de cas publiée par Anyscale. Nous vérifions la preuve publique ; les résultats sont ceux rapportés par l’éditeur.
anyscale.com- Dernière vérification
- 7 nov. 2026
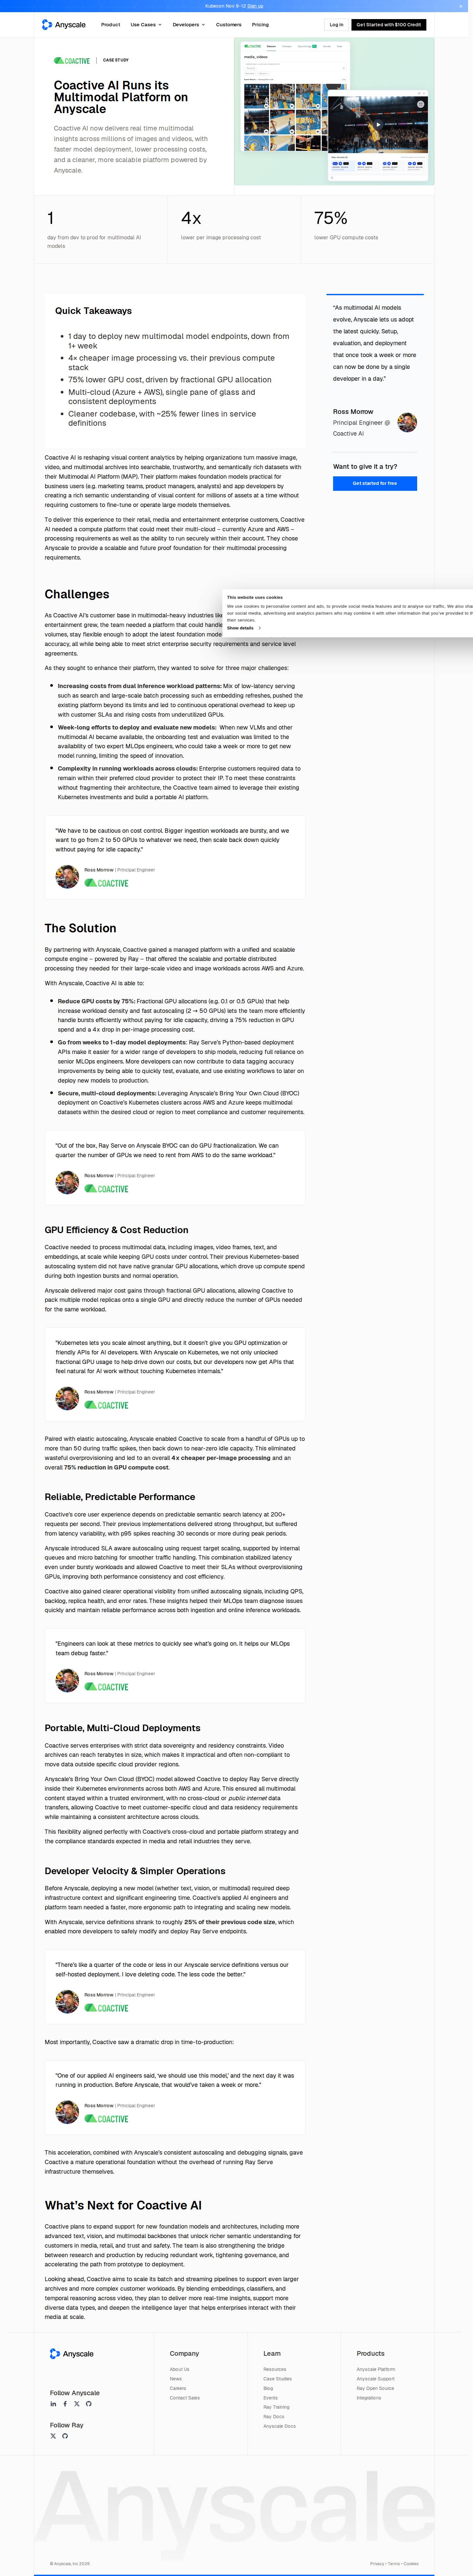 Ouvrir la capture
Ce que dit le témoignage, et ce que nous avons vérifié
Ce que nous avons comparé à la page.
- Le chiffre : 75%Vérifié
Imprimé mot pour mot sur la page, près du nom de Coactive.
- L’extrait cité plus hautVérifié
Copié mot pour mot depuis la page, près du nom de Coactive.
- Coactive utilise AnyscaleVérifié
Ligne de niveau Confirmé.
- Le résultat lui-mêmeNon vérifié
Nous le citons ; nous ne l’avons pas mesuré.
Fractional GPU allocations (e.g. 0.1 or 0.5 GPUs) that help increase workload density and fast autoscaling (2 → 50 GPUs) lets the team more efficiently handle bursts efficiently without paying for idle capacity, driving a 75% reduction in GPU spend and a 4x drop in per-image processing cost.