Comment Cursor utilise Fireworks AI
Cursor, un éditeur de code natif IA, exécute un modèle Llama-3-70b fine-tuné pour sa fonctionnalité Fast Apply sur la pile d'inférence de Fireworks AI avec une API de décodage spéculatif, ce qui permet d'appliquer rapidement des modifications de code volumineuses.
Voir la preuve capturéeL’usage : comment Cursor déploie Fireworks AI
Cursor, an AI-native code editor, runs a fine-tuned Llama-3-70b model for its Fast Apply feature on Fireworks AI's inference stack with a speculative decoding API, so large code edits are applied quickly.
Autres résultats publiés
Chiffres publiés dans l’étude de cas de Fireworks AI. usedby ne les mesure pas de façon indépendante.
a ~9x speedup over their previous GPT-4 speculative edits deployment
achieving speeds of ~1000 tokens/s (approximately 3500 char/s) on a 70b model
Le témoignage du client
...parce qu’il est bien plus performant que les moteurs open source et que c’est ce que nous utilisons en production. notre inférence rl s’adapte de façon élastique et à l’échelle mondiale grâce à lui. quand le trafic de prod est faible, nous augmentons la capacité RL ; quand il est élevé, nous la réduisons.Traduction automatique de l’anglaisVoir l’original
...because it's way more performant than the open source engines and is what we use in production. our rl inference scales elastically and globally because of it. when we have low prod traffic we scale up RL, when we have high prod traffic, we scale down RL.Fireworks a été un partenaire clé pour nous aider à entraîner et à servir à grande échelle les modèles qui font tourner Cursor. Leur plateforme prend en charge les charges de travail RL à haut débit et l’inférence en production nécessaires à Composer, ce qui nous donne la rapidité, la fiabilité et l’efficacité pour continuer à repousser les limites du codage par IA.Traduction automatique de l’anglaisVoir l’original
Fireworks has been a key partner in helping us train and serve the models behind Cursor at scale. Their platform supports the high-throughput RL workloads and production inference required for Composer, giving us the speed, reliability, and efficiency to keep pushing the frontier of AI coding.Les autres outils IA utilisés par Cursor
Autres relations publiques recensées sur usedby.
Explorer la stack IA de Cursor

Les clients de Fireworks AI dans le secteur Outils Dev & Infrastructure
Des entreprises du même secteur, avec une preuve publique.
Voir tous les clients de Fireworks AI
Consulter la source
Cette synthèse repose sur l’étude de cas publiée par Fireworks AI. Nous vérifions la preuve publique ; les résultats sont ceux rapportés par l’éditeur.
fireworks.ai- Source publiée
- 23 juin 2024
- Dernière vérification
- 11 nov. 2026
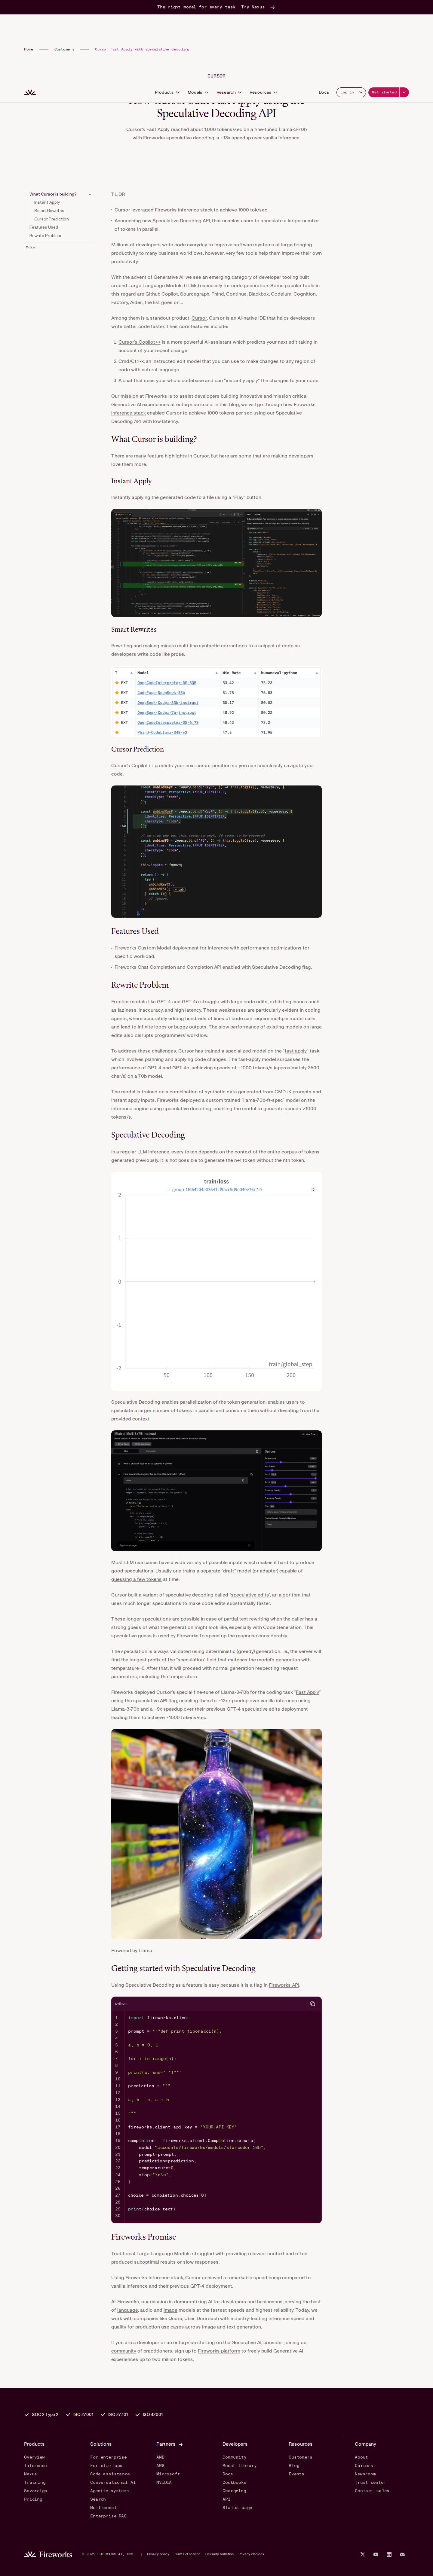 Ouvrir la capture
Ce que dit le témoignage, et ce que nous avons vérifié
Ce que nous avons comparé à la page.
- Le chiffre : ~13xVérifié
Imprimé mot pour mot sur la page, près du nom de Cursor.
- L’extrait cité plus hautVérifié
Copié mot pour mot depuis la page, près du nom de Cursor.
- Les nombres de notre résuméVérifié
Chacun est imprimé sur la page.
- La date de publicationVérifié
Lue dans les métadonnées de la page, jamais devinée.
- Cursor utilise Fireworks AIVérifié
Ligne de niveau Confirmé.
- Le résultat lui-mêmeNon vérifié
Nous le citons ; nous ne l’avons pas mesuré.
Fireworks deployed Cursor’s special fine-tune of Llama-3-70b for the coding task “Fast Apply” using the speculative API flag, enabling them to ~13x speedup over vanilla inference using Llama-3-70b and a ~9x speedup over their previous GPT-4 speculative edits deployment