Comment Hedra utilise Together AI
Hedra exécute ses modèles de génération vidéo sur les clusters GPU de Together AI pour l'entraînement et l'inférence avec mise à l'échelle automatique, via Dedicated Container Inference. Les ingénieurs de Together AI collaborent aussi à l'optimisation des kernels pour accélérer les modèles, notamment leur portage vers Blackwell.
Voir la preuve capturéeL’usage : comment Hedra déploie Together AI
Hedra runs its video generation models on Together AI's GPU clusters for training and auto-scaling inference, using Dedicated Container Inference. Together AI's engineers also collaborate on kernel optimization to speed up the models, including porting them to Blackwell.
Autres résultats publiés
Chiffres publiés dans l’étude de cas de Together AI. usedby ne les mesure pas de façon indépendante.
Recent collaboration ported Hedra's models to Blackwell architecture, achieving 3x faster inference compared to previous hardware generations.
Since seed stage, the company's compute needs have grown 300x while maintaining consistent performance and cost efficiency at massive scale.
Michael can text Together AI's team for emergency GPU additions, with 20% cluster expansions completed within hours.
Le témoignage du client
L'entraînement de notre modèle omnimodal Character-3 exigeait une infrastructure conçue pour l'IA à grande échelle. La Together Frontier AI Factory nous a apporté les performances dont nous avions besoin pour repousser les limites de la génération vidéo multimodale. Together AI comprend les besoins de ceux qui construisent, et cela a fait toute la différence.Traduction automatique de l’anglaisVoir l’original
Training our omnimodal Character-3 model required infrastructure designed for large-scale AI. The Together Frontier AI Factory delivered the performance we needed to push the boundaries of multimodal video generation. Together AI understands what builders need — and that made all the difference.L'infrastructure de Together AI a la capacité d'absorber nos pics de viralité sans broncher. Lors des fortes hausses de trafic, Dedicated Container Inference s'adapte sans accroc tout en maintenant les performances. Et comme nous avons entraîné nos modèles sur l'Accelerated Compute de Together, le déploiement en production s'est fait sans friction : une seule plateforme, aucun transfert d'artefacts, aucun casse-tête de déploiement.Traduction automatique de l’anglaisVoir l’original
Together AI’s infrastructure has the capacity to soak up our viral moments without breaking a sweat. During major traffic surges, Dedicated Container Inference scales seamlessly while maintaining performance. And because we trained on Together’s Accelerated Compute, deploying to production was frictionless—one platform, zero artifact transfers, no deployment headaches.Les autres outils IA utilisés par Hedra
Autres relations publiques recensées sur usedby.
Explorer la stack IA de Hedra
Les clients de Together AI dans le secteur Intelligence artificielle
Des entreprises du même secteur, avec une preuve publique.
 Arcee AIConfirmé
 CartesiaConfirmé
 DecagonConfirmé
 Deep CogitoConfirmé
 Dippy AIConfirmé
 LegionEdgeConfirmé
Consulter la source
Cette synthèse repose sur l’étude de cas publiée par Together AI. Nous vérifions la preuve publique ; les résultats sont ceux rapportés par l’éditeur.
together.ai- Dernière vérification
- 21 nov. 2026
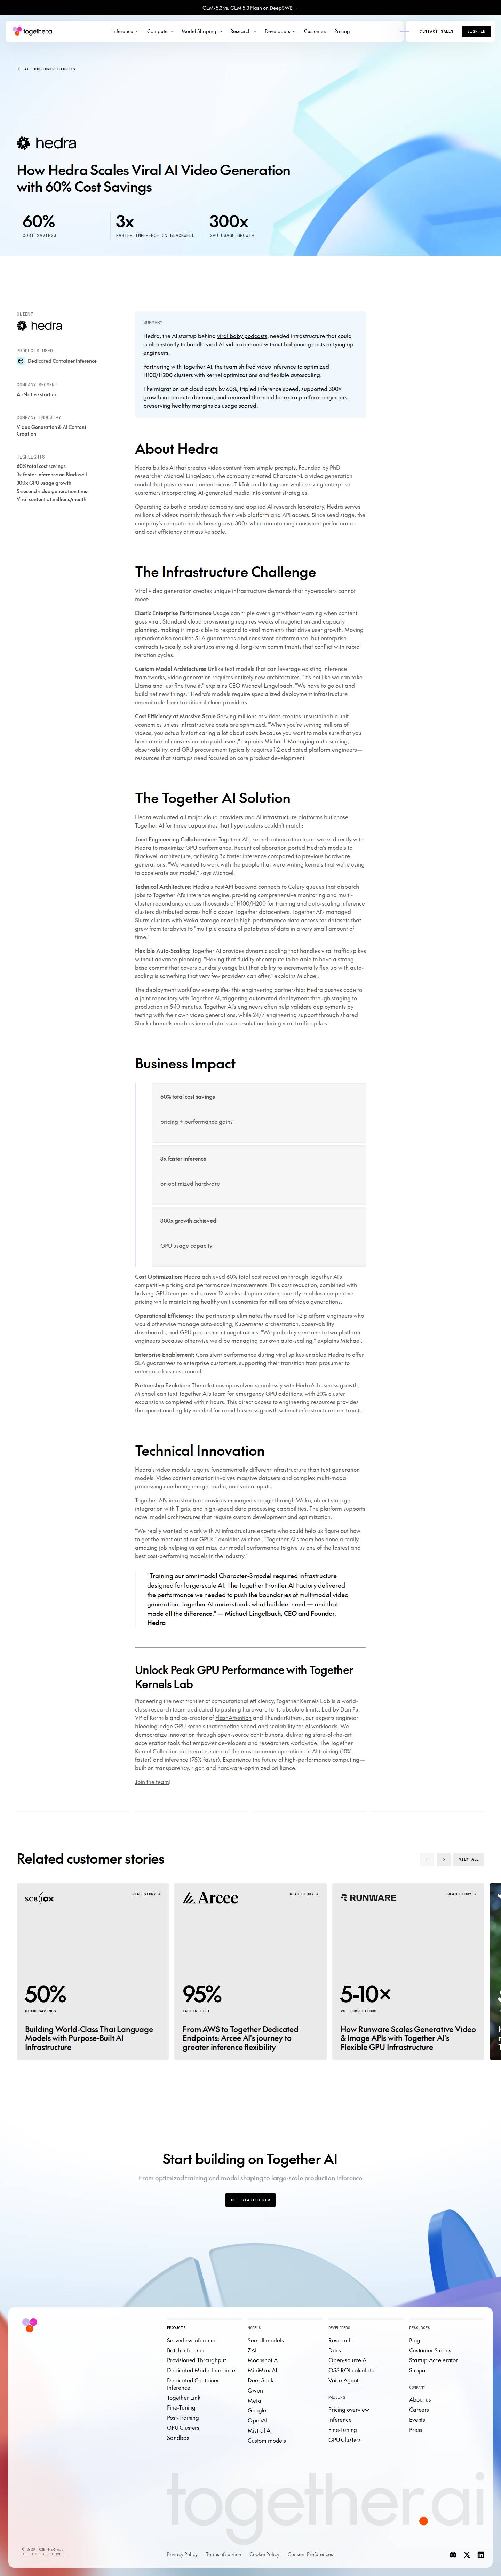 Ouvrir la capture
Ce que dit le témoignage, et ce que nous avons vérifié
Ce que nous avons comparé à la page.
- Le chiffre : 60%Vérifié
Imprimé mot pour mot sur la page, près du nom de Hedra.
- L’extrait cité plus hautVérifié
Copié mot pour mot depuis la page, près du nom de Hedra.
- Hedra utilise Together AIVérifié
Ligne de niveau Confirmé.
- Le résultat lui-mêmeNon vérifié
Nous le citons ; nous ne l’avons pas mesuré.
Hedra achieved 60% total cost reduction through Together AI's competitive pricing and performance improvements. This cost reduction, combined with halving GPU time per video over 12 weeks of optimization, directly enables competitive pricing while maintaining healthy unit economics for millions of video generations.