L’usage : comment HubSpot déploie Fivetran
HubSpot's People Operations team uses Fivetran to replace fragile DIY pipelines and spreadsheet imports, ingesting data from Workday, Greenhouse, Survey Monkey and FP&A spreadsheets into Snowflake. The centralized data supports workforce planning, hiring forecasts, eNPS analysis and generative AI initiatives on employee performance.
Autres résultats publiés
Chiffres publiés dans l’étude de cas de Fivetran. usedby ne les mesure pas de façon indépendante.
Reduced pipeline development from 6-10 weeks to under an hour
Now, forecasts are 90-95% accurate to what happens.
leading to a 150% ROI
Within two days, 90 percent of managers have pulled their personalized eNPS insights.
Le témoignage du client
In our first year with Fivetran, we built 40+ different pipelines for nearly 700 tables, which handle nearly 40 million records every month. It took fewer than 40 hours to build it all, saving us nearly 1,000 hours and $100,000 across multiple departments, leading to a 150% ROI.Les autres outils IA utilisés par HubSpot
Autres relations publiques recensées sur usedby.
Explorer la stack IA de HubSpot
Les autres entreprises qui utilisent Fivetran
Des clients de différents secteurs, avec une preuve publique.
 AxonConfirmé
 BoatsetterConfirmé
 BraunAbilityConfirmé
 CaliberMindConfirmé
 Inova HealthConfirmé
 LVMHConfirmé
Consulter la source
Cette synthèse repose sur l’étude de cas publiée par Fivetran. Nous vérifions la preuve publique ; les résultats sont ceux rapportés par l’éditeur.
fivetran.com- Dernière vérification
- 12 nov. 2026
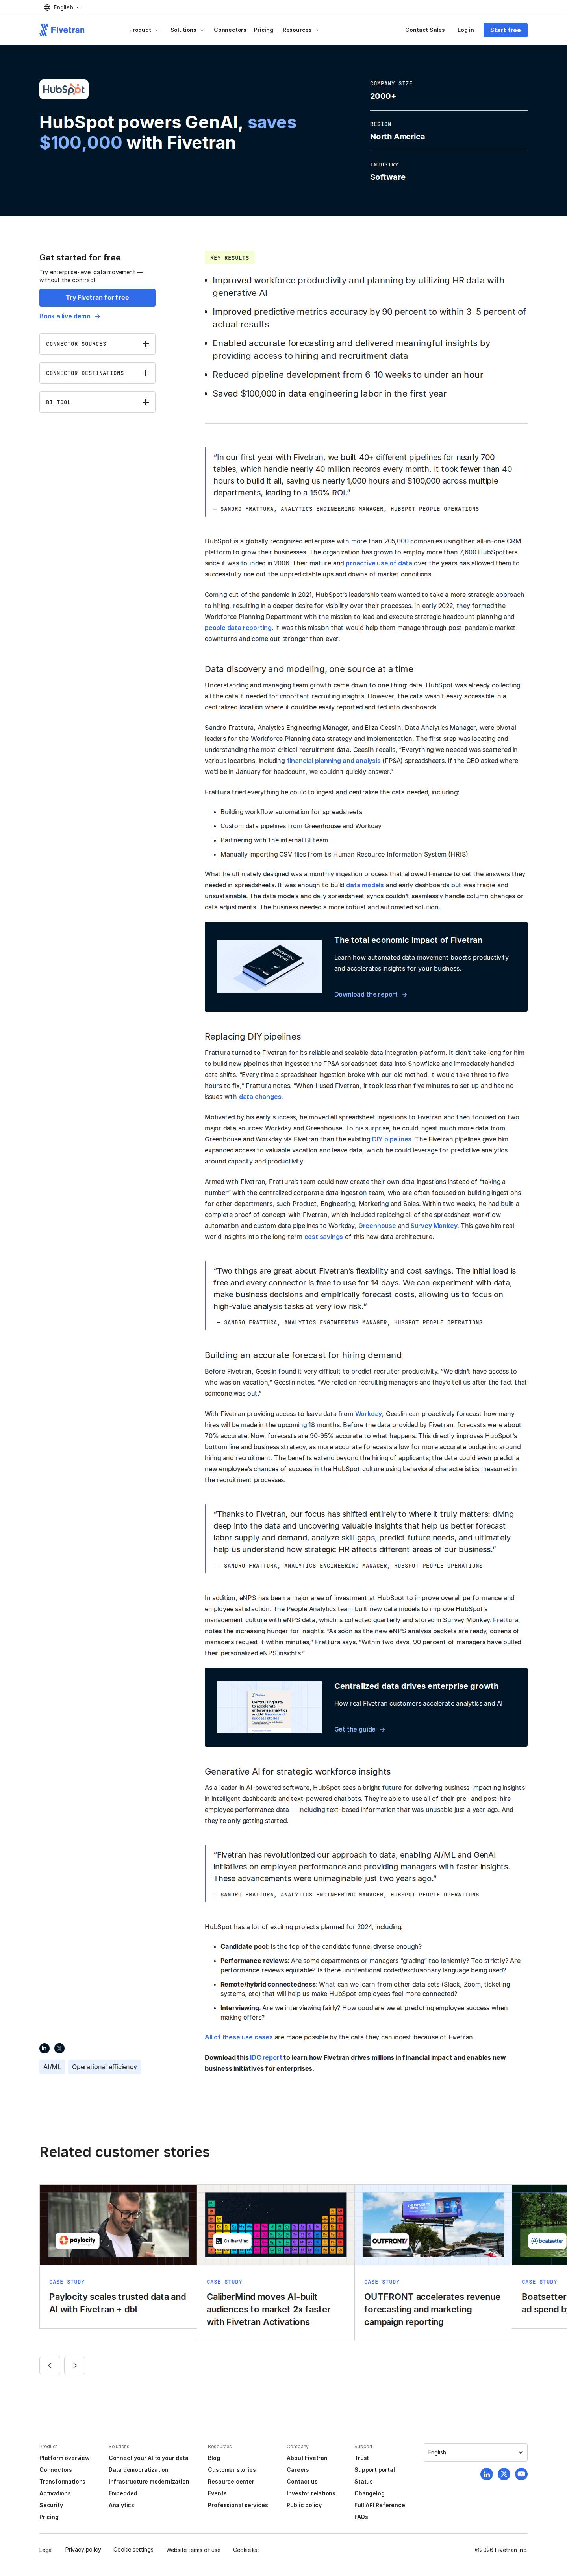 Ouvrir la capture
Ce que dit le témoignage, et ce que nous avons vérifié
Ce que nous avons comparé à la page.
- Le chiffre : $100,000Vérifié
Imprimé mot pour mot sur la page, près du nom de HubSpot.
- L’extrait cité plus hautVérifié
Copié mot pour mot depuis la page, près du nom de HubSpot.
- HubSpot utilise FivetranVérifié
Ligne de niveau Confirmé.
- Le résultat lui-mêmeNon vérifié
Nous le citons ; nous ne l’avons pas mesuré.
In our first year with Fivetran, we built 40+ different pipelines for nearly 700 tables, which handle nearly 40 million records every month. It took fewer than 40 hours to build it all, saving us nearly 1,000 hours and $100,000