Comment Samsara utilise Databricks
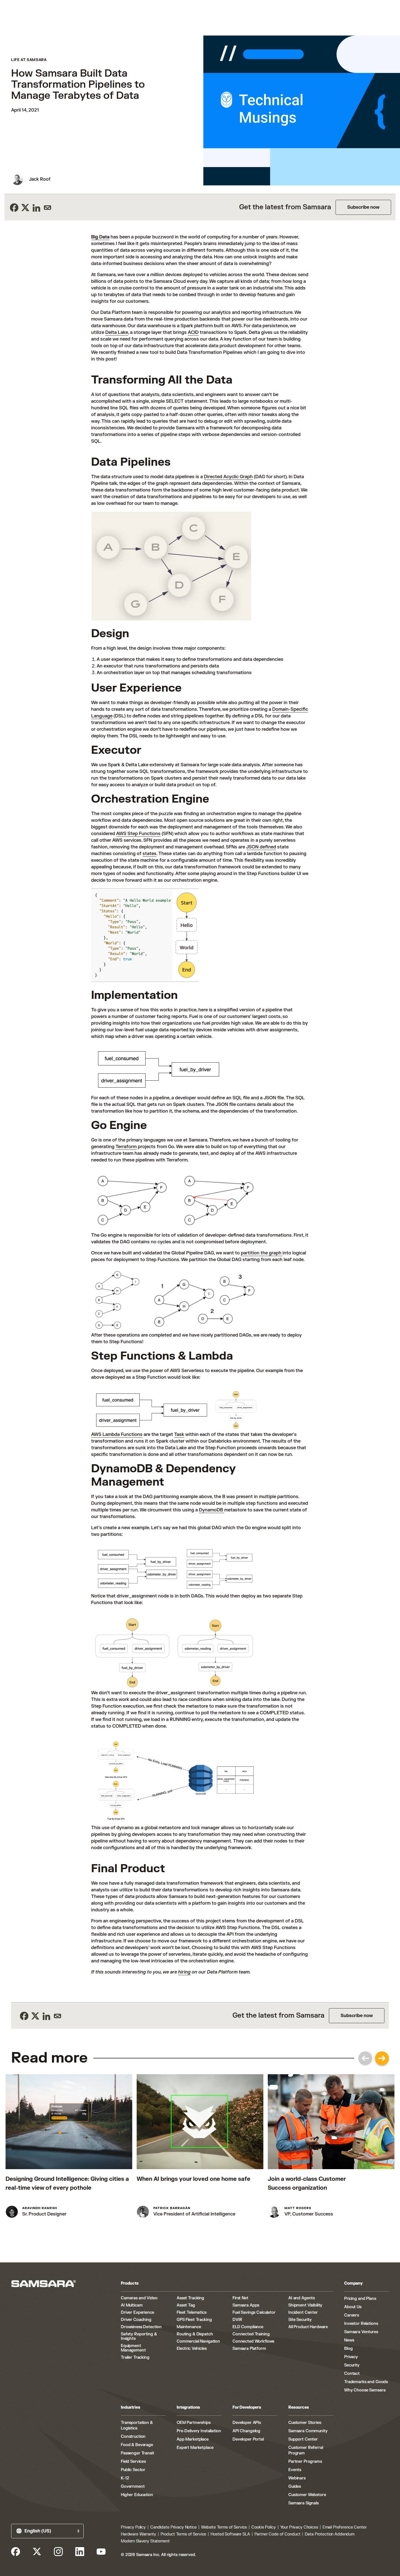
L'équipe Data Platform de Samsara a conçu un framework pour définir et exécuter des pipelines de transformation de données basés sur SQL. Des fonctions AWS Lambda exécutent chaque transformation sur des clusters Spark au sein de l'environnement Databricks de Samsara, et les résultats sont écrits dans le data lake.
Voir la preuve capturéeL’usage : comment Samsara déploie Databricks
Samsara's Data Platform team built a framework for defining and running SQL-based data transformation pipelines. AWS Lambda functions run each transformation on Spark clusters within Samsara's Databricks environment, and the results are written to the data lake.
Les autres outils IA utilisés par Samsara
Autres relations publiques recensées sur usedby.
Explorer la stack IA de Samsara
Les clients de Databricks dans le secteur Logistique et chaîne d'approvisionnement
Des entreprises du même secteur, avec une preuve publique.
Voir tous les clients de Databricks
Consulter la source
Cette synthèse repose sur la page où Samsara décrit son usage de Databricks. Nous vérifions la preuve publique ; les résultats sont ceux rapportés par l’entreprise.
samsara.com- Dernière vérification
- 11 nov. 2026
 Ouvrir la capture
Ce que dit le témoignage, et ce que nous avons vérifié
Ce que nous avons comparé à la page.
- L’extrait cité plus hautVérifié
Copié mot pour mot depuis la page, près du nom de Samsara.
- Samsara utilise DatabricksVérifié
Ligne de niveau Confirmé.
- Le résultat lui-mêmeNon vérifié
Nous le citons ; nous ne l’avons pas mesuré.
AWS Lambda Functions are the target Task within each of the states that takes the developer's transformation and runs it on Spark cluster within our Databricks environment.