Comment vLLM utilise Nebius AI Cloud
vLLM, un framework open source d'inférence de LLM, utilise les clusters de calcul de Nebius pour tester, évaluer et optimiser l'inférence de grands modèles tels que DeepSeek R1 sur différents types de calcul accéléré. Il utilise aussi les disques non répliqués de Nebius pour stocker les poids de grands modèles avec un débit élevé.
Voir la preuve capturéeL’usage : comment vLLM déploie Nebius AI Cloud
vLLM, an open-source LLM inference framework, uses Nebius compute clusters to test, benchmark and optimize inference for large models such as DeepSeek R1 across different accelerated compute types. It also uses Nebius non-replicated disks to store large model weights with high throughput.
Les clients de Nebius AI Cloud dans le secteur Intelligence artificielle
Des entreprises du même secteur, avec une preuve publique.
 DubformerConfirméHelicalConfirmé
 HiggsfieldConfirmé
 KrispConfirméPositronic RoboticsConfirmé
 Prime IntellectConfirmé
Consulter la source
Cette synthèse repose sur l’étude de cas publiée par Nebius AI Cloud. Nous vérifions la preuve publique ; les résultats sont ceux rapportés par l’éditeur.
nebius.com- Dernière vérification
- 15 nov. 2026
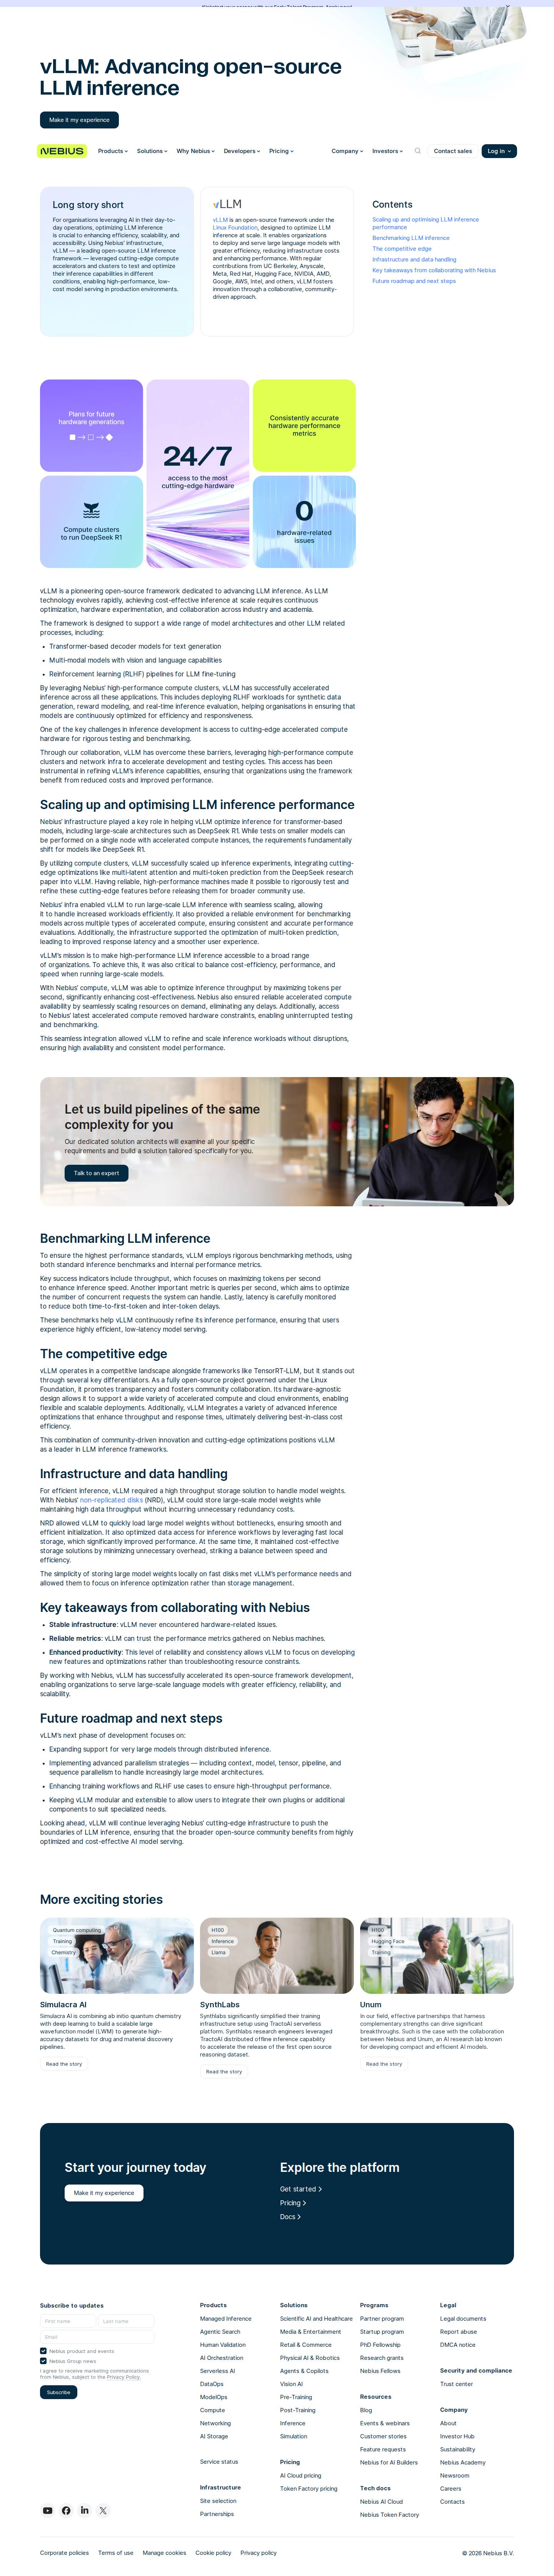 Ouvrir la capture
Ce que dit le témoignage, et ce que nous avons vérifié
Ce que nous avons comparé à la page.
- L’extrait cité plus hautVérifié
Copié mot pour mot depuis la page, près du nom de vLLM.
- vLLM utilise Nebius AI CloudVérifié
Ligne de niveau Confirmé.
- Le résultat lui-mêmeNon vérifié
Nous le citons ; nous ne l’avons pas mesuré.
By utilizing compute clusters, vLLM successfully scaled up inference experiments, integrating cutting-edge optimizations like multi-latent attention and multi-token prediction from the DeepSeek research paper into vLLM.