Como Cursor usa Fireworks AI
A Cursor, um editor de código nativo de IA, executa um modelo Llama-3-70b com ajuste fino no recurso Fast Apply, usando a stack de inferência da Fireworks AI com uma API de decodificação especulativa, para que grandes edições de código sejam aplicadas rapidamente.
Ver a prova capturadaO caso de uso: como Cursor implanta Fireworks AI
Cursor, an AI-native code editor, runs a fine-tuned Llama-3-70b model for its Fast Apply feature on Fireworks AI's inference stack with a speculative decoding API, so large code edits are applied quickly.
Outros resultados informados
Números publicados no estudo de caso de Fireworks AI. Eles não são medidos de forma independente pelo usedby.
a ~9x speedup over their previous GPT-4 speculative edits deployment
achieving speeds of ~1000 tokens/s (approximately 3500 char/s) on a 70b model
Nas palavras do cliente
...porque ela tem um desempenho muito superior ao dos engines de código aberto e é o que usamos em produção. Por causa dela, nossa inferência de RL escala de forma elástica e global. Quando o tráfego de produção está baixo, aumentamos o RL; quando o tráfego de produção está alto, reduzimos o RL.Tradução automática do inglêsVer o original
...because it's way more performant than the open source engines and is what we use in production. our rl inference scales elastically and globally because of it. when we have low prod traffic we scale up RL, when we have high prod traffic, we scale down RL.A Fireworks tem sido uma parceira essencial para nos ajudar a treinar e servir em escala os modelos por trás do Cursor. A plataforma deles suporta as cargas de trabalho de RL de alto throughput e a inferência em produção exigidas pelo Composer, dando-nos a velocidade, a confiabilidade e a eficiência para continuar expandindo a fronteira da programação com IA.Tradução automática do inglêsVer o original
Fireworks has been a key partner in helping us train and serve the models behind Cursor at scale. Their platform supports the high-throughput RL workloads and production inference required for Composer, giving us the speed, reliability, and efficiency to keep pushing the frontier of AI coding.Outras ferramentas de IA usadas por Cursor
Outras relações públicas registradas no usedby.
Explorar a stack de IA de Cursor

Usuários de Fireworks AI no setor DevTools e infraestrutura
Empresas do mesmo setor, com evidências públicas.
Ver todos os clientes de Fireworks AI
Ir direto à fonte
Com base no estudo de caso publicado por Fireworks AI. Verificamos as evidências públicas; os resultados são informados pelo fornecedor.
fireworks.ai- Fonte publicada em
- 23 de jun. de 2024
- Última verificação
- 11 de nov. de 2026
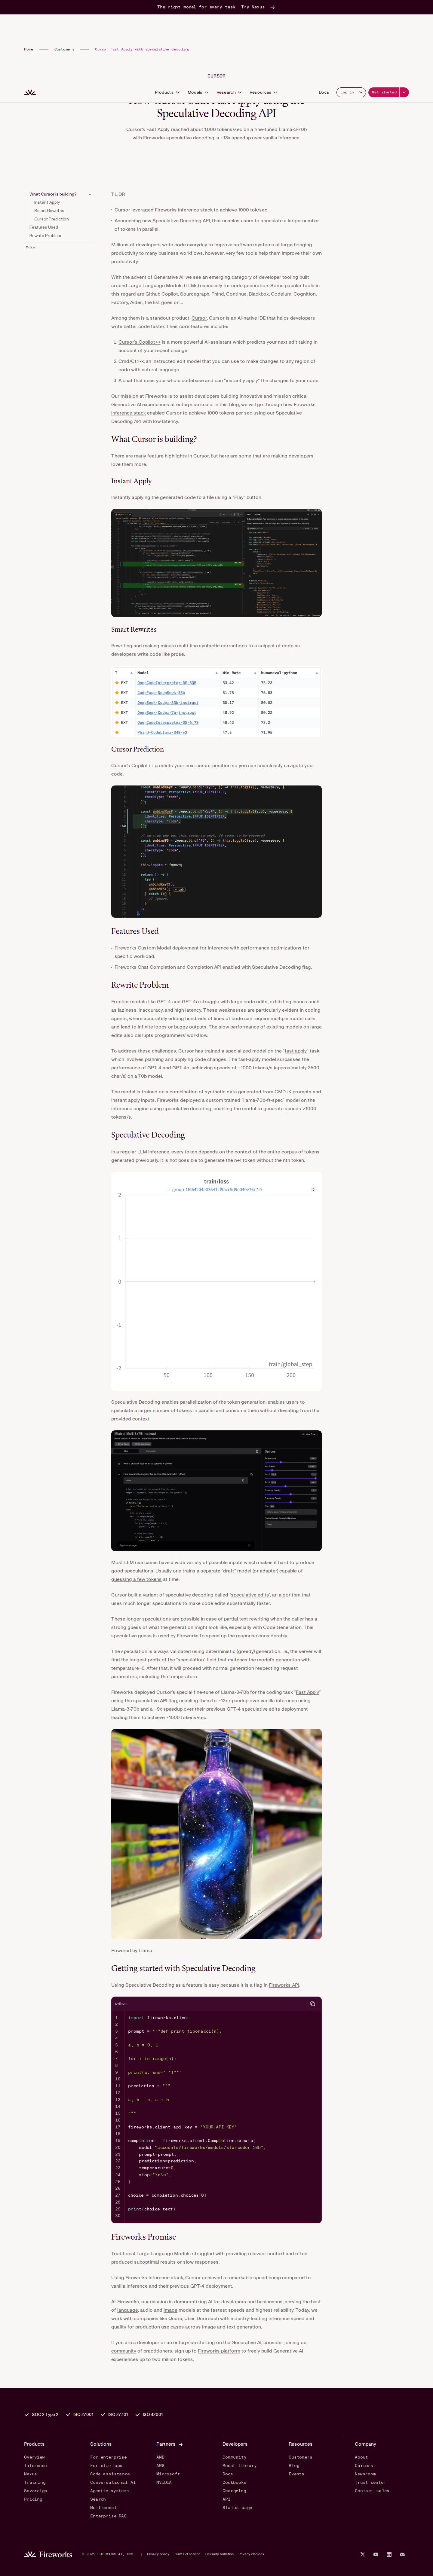 Abrir a captura da fonte
O que o estudo de caso afirma e o que verificamos
O que comparamos com a página.
- O número: ~13xVerificado
Impresso palavra por palavra na página, perto do nome de Cursor.
- O trecho citado acimaVerificado
Copiado palavra por palavra da página, perto do nome de Cursor.
- Os números do nosso resumoVerificado
Cada um está impresso na página.
- A data de publicaçãoVerificado
Lida nos próprios metadados da página, nunca adivinhada.
- Cursor usa Fireworks AIVerificado
Linha de nível Confirmado.
- O resultado em siNão verificado
Nós o citamos; não o medimos.
Fireworks deployed Cursor’s special fine-tune of Llama-3-70b for the coding task “Fast Apply” using the speculative API flag, enabling them to ~13x speedup over vanilla inference using Llama-3-70b and a ~9x speedup over their previous GPT-4 speculative edits deployment