Cómo Nayya utiliza Labelbox
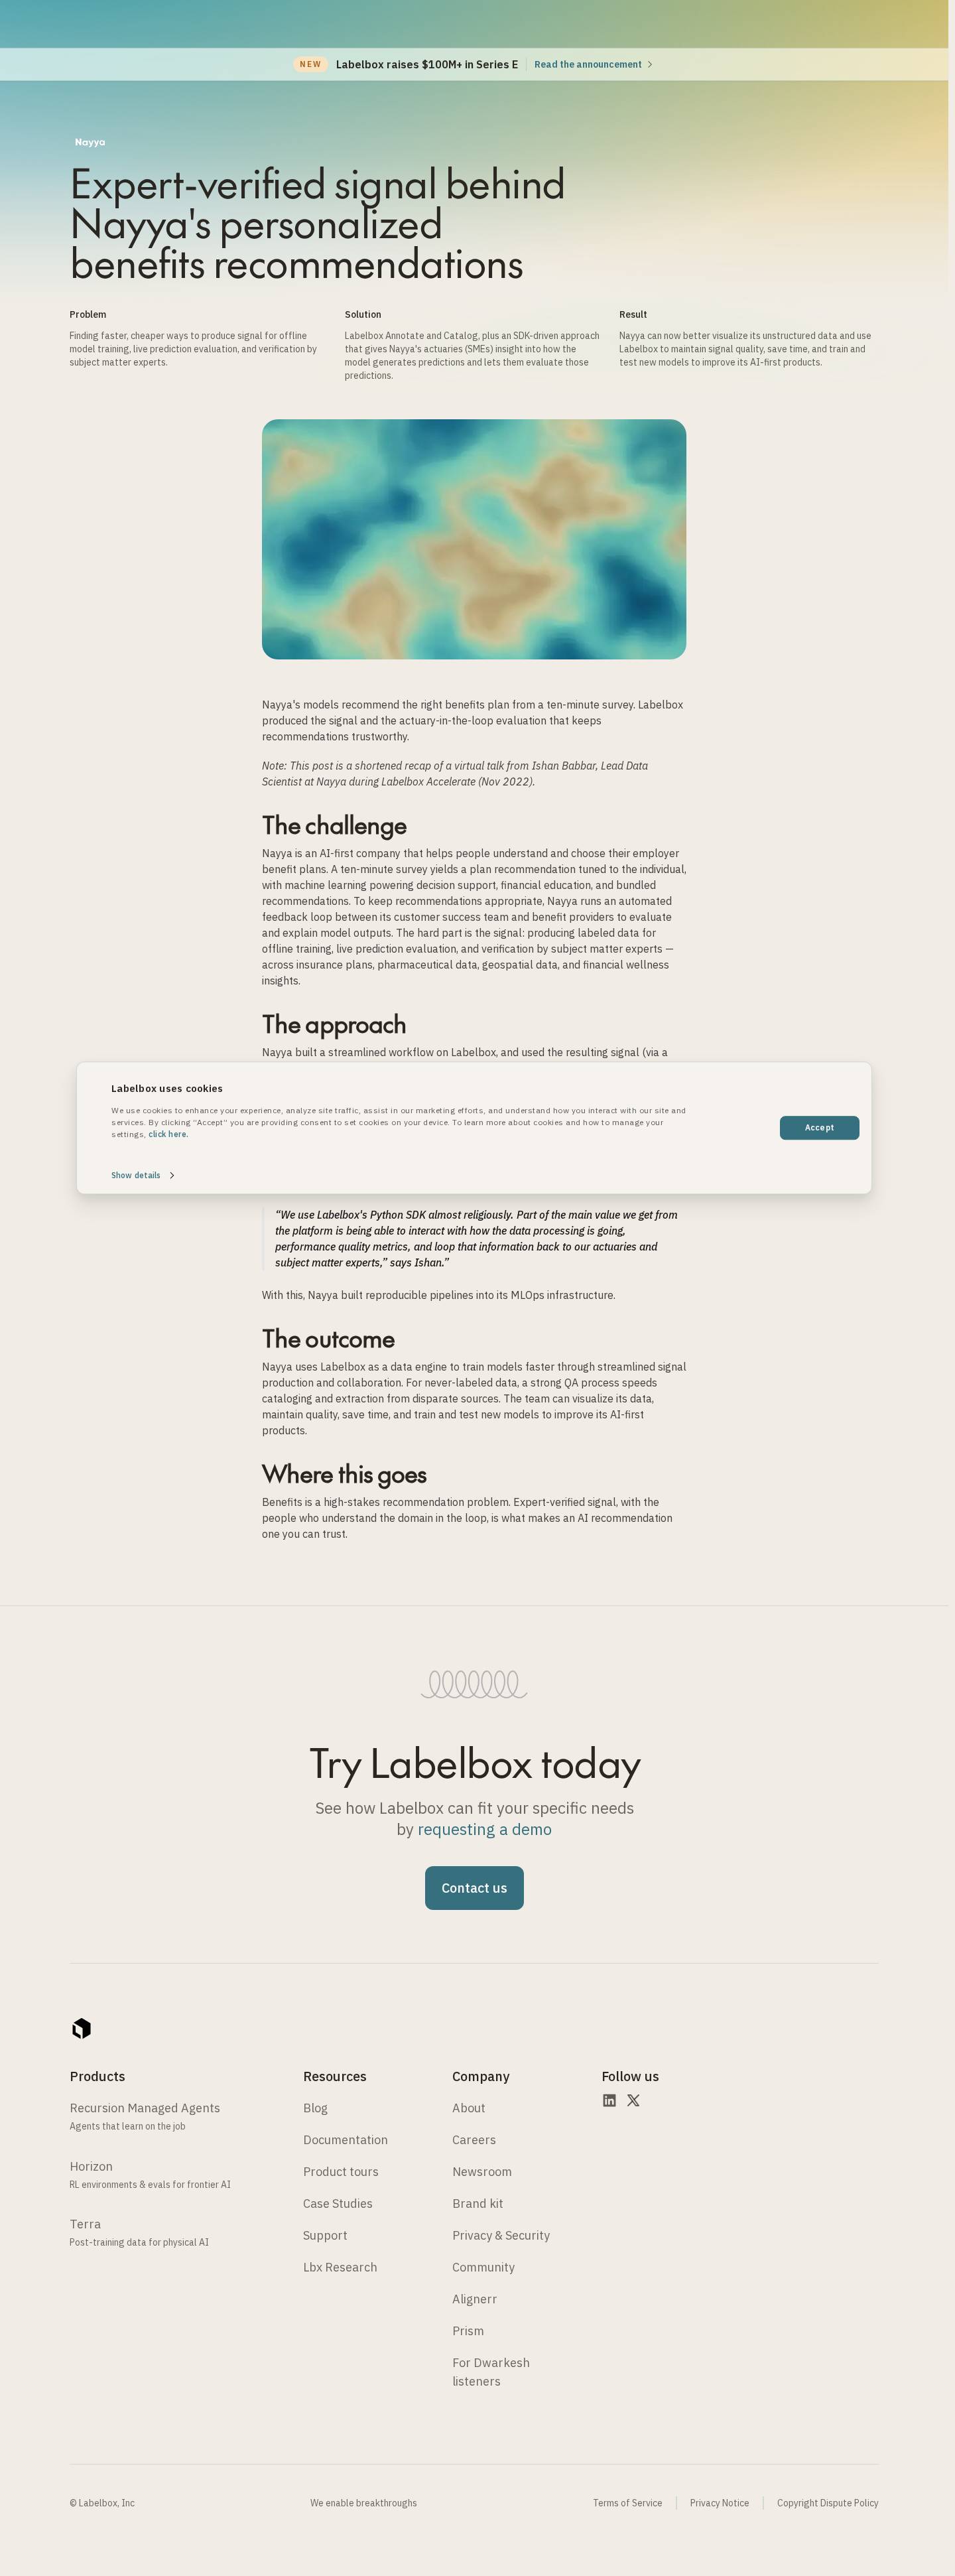
Nayya utiliza Labelbox para generar datos etiquetados destinados al entrenamiento de modelos sin conexión, la evaluación de predicciones en tiempo real y la verificación por expertos de las recomendaciones de sus planes de beneficios. Sus actuarios emplean el SDK de Python y el flujo de trabajo asistido por modelos para revisar cómo el modelo genera las predicciones y evaluarlas.
Ver la prueba capturadaEl uso: cómo Nayya implementa Labelbox
Nayya uses Labelbox to produce labeled data for offline model training, live prediction evaluation, and expert verification of its benefits plan recommendations. Its actuaries use the Python SDK and model-assisted workflow to review how the model generates predictions and evaluate them.
En palabras del cliente
El flujo de trabajo asistido por modelos de Labelbox nos permite hacerlo a gran escala y crear un proceso repetible tanto para nuestros científicos de datos como para los expertos en la materia que trabajan con nosotros,Traducción automática del inglésVer el original
The model-assisted workflow within Labelbox allows us to do this at scale and build a repeatable process for our data scientists as well as any subject matter experts that work with us,Otras empresas que utilizan Labelbox
Clientes de distintos sectores, con pruebas públicas.
 AncestryConfirmado
 Blue River TechnologyConfirmado
 BurberryConfirmado
 CAPE AnalyticsConfirmado
 CriteoConfirmado
Consultar la fuente
Basado en el caso de éxito publicado por Labelbox. Verificamos las pruebas públicas; los resultados son los que declara el proveedor.
labelbox.com- Última verificación
- 17 nov 2026
 Abrir la captura
Lo que dice la historia, y lo que verificamos
Lo que comparamos con la página.
- El pasaje citado arribaVerificado
Copiado palabra por palabra de la página, cerca del nombre de Nayya.
- Nayya usa LabelboxVerificado
Línea de nivel Confirmado.
- El resultado en síNo verificado
Lo citamos; no lo medimos.
Nayya uses Labelbox as a data engine to train models faster through streamlined signal production and collaboration. For never-labeled data, a strong QA process speeds cataloging and extraction from disparate sources.