L’usage : comment Wispr Flow déploie Baseten
Wispr Flow runs fine-tuned Llama models for real-time transcript cleanup on Baseten's dedicated deployments, hosted on AWS. The models and its speech recognition pipeline power voice dictation across applications, using Baseten's TensorRT-LLM engine builder, Chains framework and autoscaling GPUs.
Autres résultats publiés
Chiffres publiés dans l’étude de cas de Baseten. usedby ne les mesure pas de façon indépendante.
To hit this latency target, the Llama model must consistently process and generate 100+ tokens in under 250 milliseconds.
Le témoignage du client
Avec Baseten, nous avons gagné beaucoup de contrôle sur l'ensemble de notre pipeline d'inférence et nous avons travaillé avec l'équipe de Baseten pour optimiser chaque étape.Traduction automatique de l’anglaisVoir l’original
With Baseten, we gained a lot of control over our entire inference pipeline and worked with Baseten’s team to optimize each step.Les autres outils IA utilisés par Wispr Flow
Autres relations publiques recensées sur usedby.
Explorer la stack IA de Wispr Flow
Les clients de Baseten dans le secteur Intelligence Artificielle
Des entreprises du même secteur, avec une preuve publique.
 EliseAIConfirmé
 GammaConfirmé
 HebbiaConfirmé
 Oxen AIConfirmé
 Parallel Web SystemsConfirmé
 PoolsideConfirmé
Consulter la source
Cette synthèse repose sur l’étude de cas publiée par Baseten. Nous vérifions la preuve publique ; les résultats sont ceux rapportés par l’éditeur.
baseten.co- Dernière vérification
- 11 nov. 2026
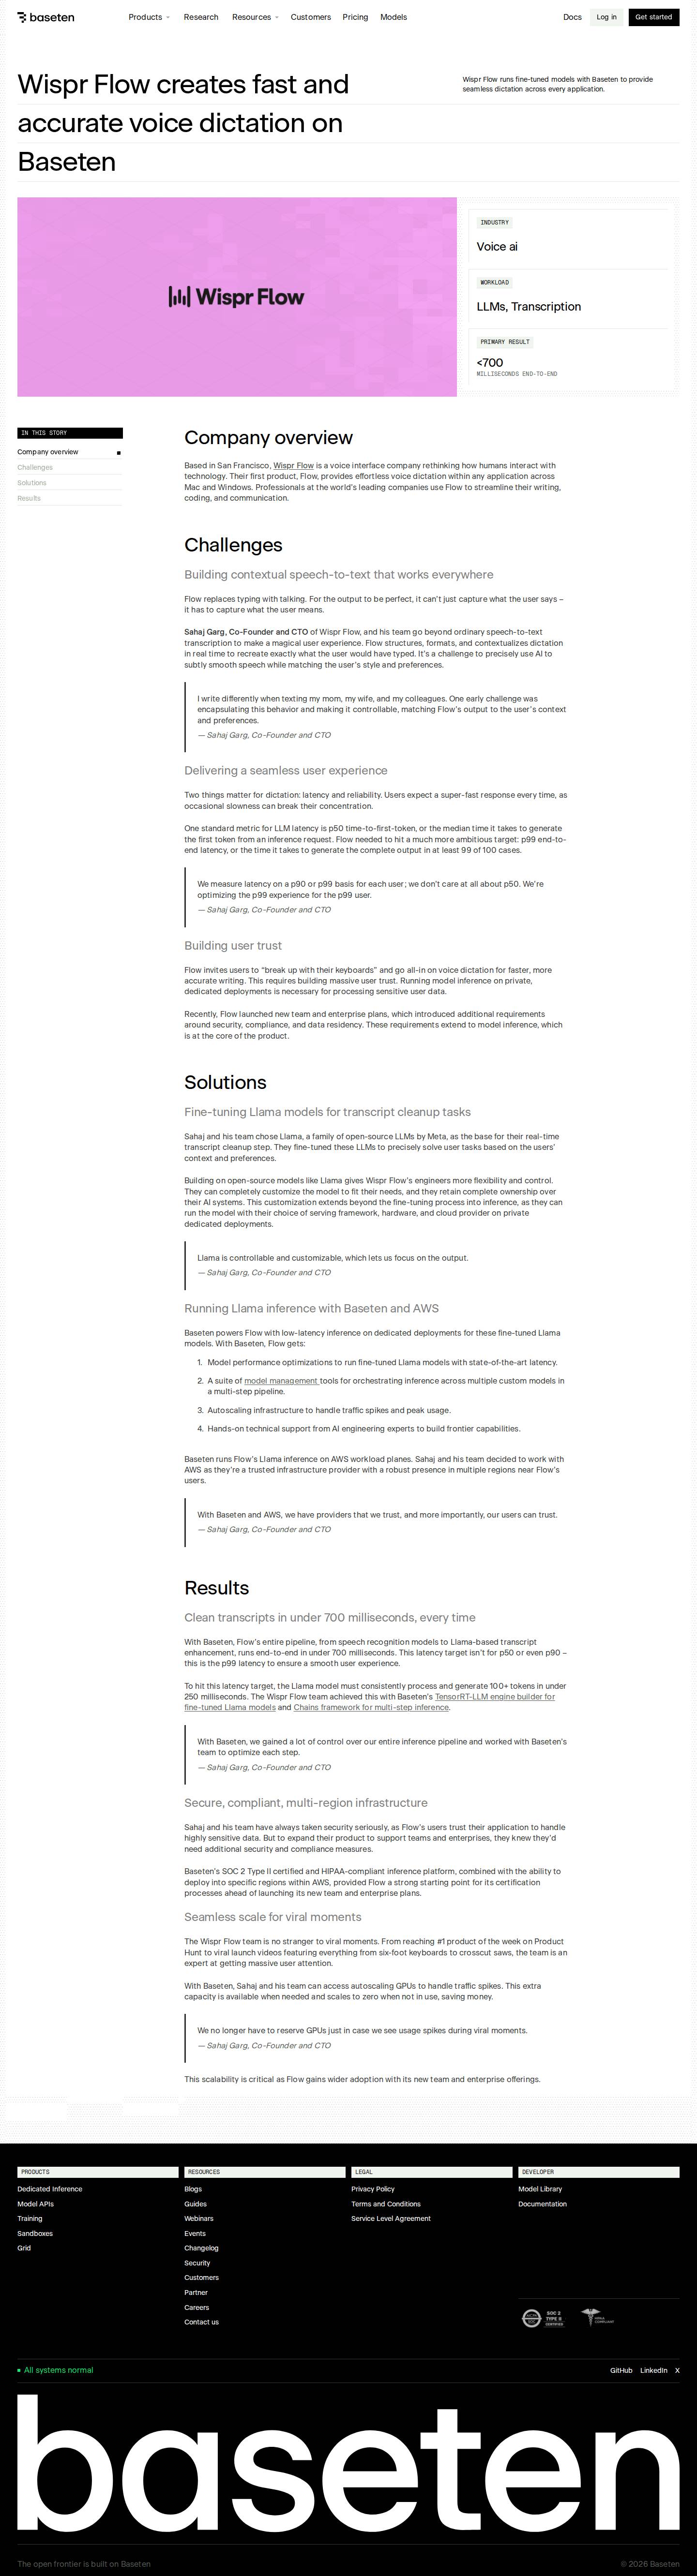 Ouvrir la capture
Ce que dit le témoignage, et ce que nous avons vérifié
Ce que nous avons comparé à la page.
- Le chiffre : 700 millisecondsVérifié
Imprimé mot pour mot sur la page, près du nom de Wispr Flow.
- L’extrait cité plus hautVérifié
Copié mot pour mot depuis la page, près du nom de Wispr Flow.
- Wispr Flow utilise BasetenVérifié
Ligne de niveau Confirmé.
- Le résultat lui-mêmeNon vérifié
Nous le citons ; nous ne l’avons pas mesuré.
With Baseten, Flow’s entire pipeline, from speech recognition models to Llama-based transcript enhancement, runs end-to-end in under 700 milliseconds. This latency target isn’t for p50 or even p90 – this is the p99 latency to ensure a smooth user experience.