Comment Yutori utilise Together AI
Yutori exécute son modèle propriétaire d'utilisation du navigateur, Navigator, sur la plateforme d'inférence serverless de Together AI. La plateforme alimente ses produits d'agents Scouts et Delegate ainsi que son API publique pour développeurs, et prend en charge aussi bien les charges de travail d'agents en arrière-plan qu'en temps réel.
Voir la preuve capturéeL’usage : comment Yutori déploie Together AI
Yutori runs its proprietary browser-use model, Navigator, on Together AI's serverless inference platform. The platform serves its Scouts and Delegate agent products and its public developer API, covering both background and real-time agent workloads.
Le témoignage du client
Travailler avec Together AI a permis à Yutori de monter en charge sans défaillance. C'est important.Traduction automatique de l’anglaisVoir l’original
Working with Together AI has allowed Yutori to scale without failures. That's important.Les autres outils IA utilisés par Yutori
Autres relations publiques recensées sur usedby.
Explorer la stack IA de Yutori
Les clients de Together AI dans le secteur Intelligence artificielle
Des entreprises du même secteur, avec une preuve publique.
Voir tous les clients de Together AI
Consulter la source
Cette synthèse repose sur l’étude de cas publiée par Together AI. Nous vérifions la preuve publique ; les résultats sont ceux rapportés par l’éditeur.
together.ai- Dernière vérification
- 3 oct. 2026
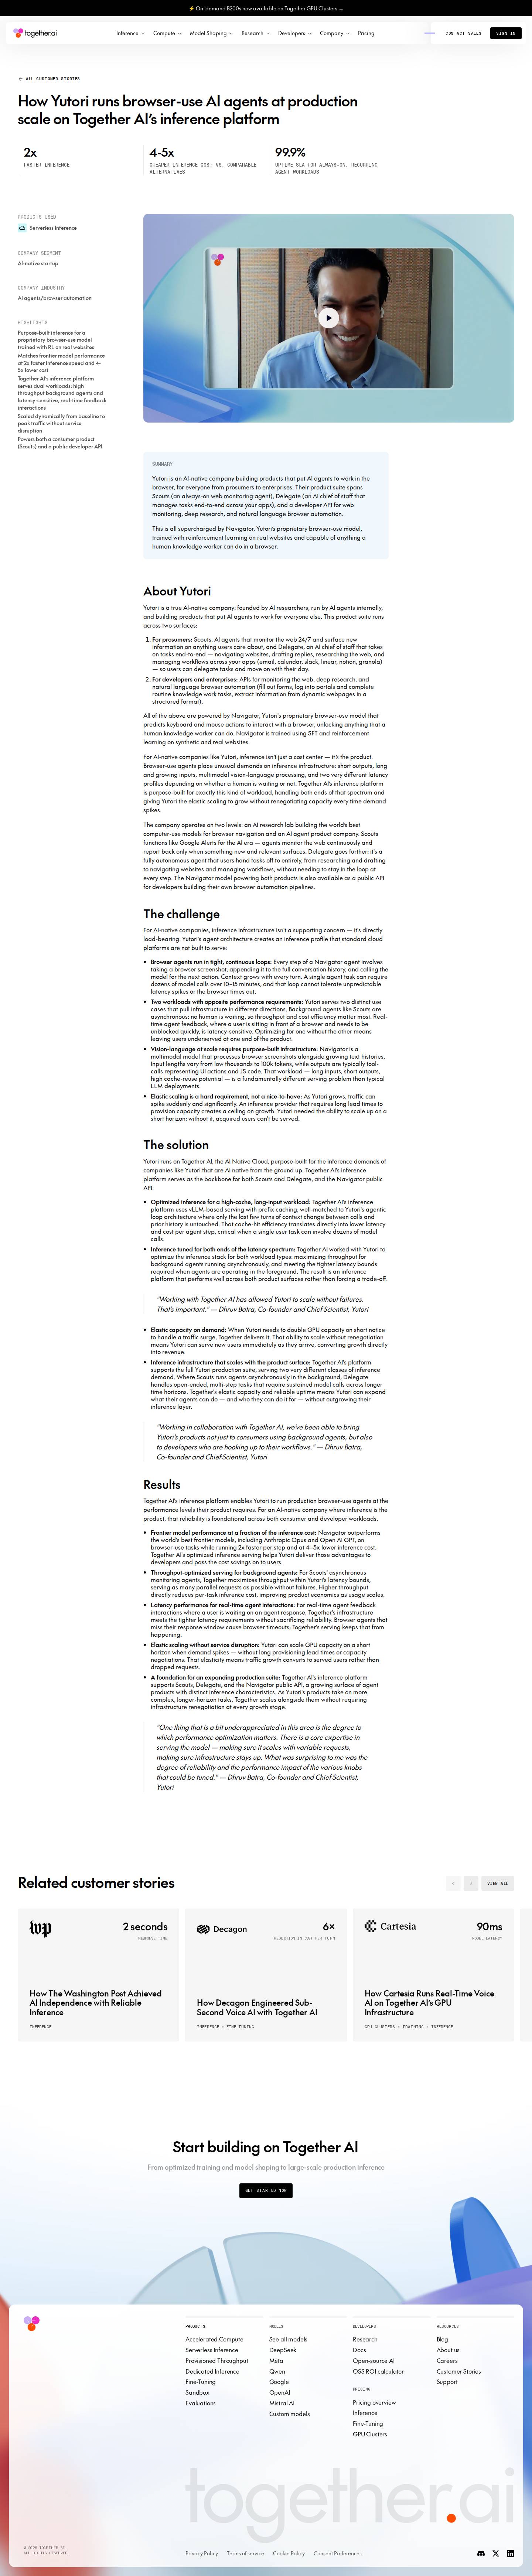 Ouvrir la capture
Ce que dit le témoignage, et ce que nous avons vérifié
Ce que nous avons comparé à la page.
- Le chiffre : 4–5xVérifié
Imprimé mot pour mot sur la page, près du nom de Yutori.
- L’extrait cité plus hautVérifié
Copié mot pour mot depuis la page, près du nom de Yutori.
- Yutori utilise Together AIVérifié
Ligne de niveau Confirmé.
- Le résultat lui-mêmeNon vérifié
Nous le citons ; nous ne l’avons pas mesuré.
Navigator outperforms the world's best frontier models, including Anthropic Opus and Open AI GPT, on browser-use tasks while running 2x faster per step and at 4–5x lower inference cost.