Cómo Wispr Flow utiliza Baseten
Wispr Flow ejecuta modelos Llama ajustados (fine-tuned) para limpiar transcripciones en tiempo real en los despliegues dedicados de Baseten, alojados en AWS. Los modelos y su pipeline de reconocimiento de voz impulsan el dictado por voz en distintas aplicaciones, con el constructor de motores TensorRT-LLM de Baseten, el framework Chains y GPU con escalado automático.
Ver la prueba capturadaEl uso: cómo Wispr Flow implementa Baseten
Wispr Flow runs fine-tuned Llama models for real-time transcript cleanup on Baseten's dedicated deployments, hosted on AWS. The models and its speech recognition pipeline power voice dictation across applications, using Baseten's TensorRT-LLM engine builder, Chains framework and autoscaling GPUs.
Otros resultados publicados
Cifras publicadas en el caso de estudio de Baseten. usedby no las mide de forma independiente.
To hit this latency target, the Llama model must consistently process and generate 100+ tokens in under 250 milliseconds.
En palabras del cliente
Con Baseten, ganamos mucho control sobre todo nuestro pipeline de inferencia y trabajamos con el equipo de Baseten para optimizar cada paso.Traducción automática del inglésVer el original
With Baseten, we gained a lot of control over our entire inference pipeline and worked with Baseten’s team to optimize each step.Otras herramientas de IA utilizadas por Wispr Flow
Otras relaciones públicas registradas en usedby.
Explorar las herramientas de IA de Wispr Flow
Clientes de Baseten en Inteligencia Artificial
Empresas del mismo sector, con pruebas públicas.
 EliseAIConfirmado
 GammaConfirmado
 HebbiaConfirmado
 Oxen AIConfirmado
 Parallel Web SystemsConfirmado
 PoolsideConfirmado
Consultar la fuente
Basado en el caso de éxito publicado por Baseten. Verificamos las pruebas públicas; los resultados son los que declara el proveedor.
baseten.co- Última verificación
- 11 nov 2026
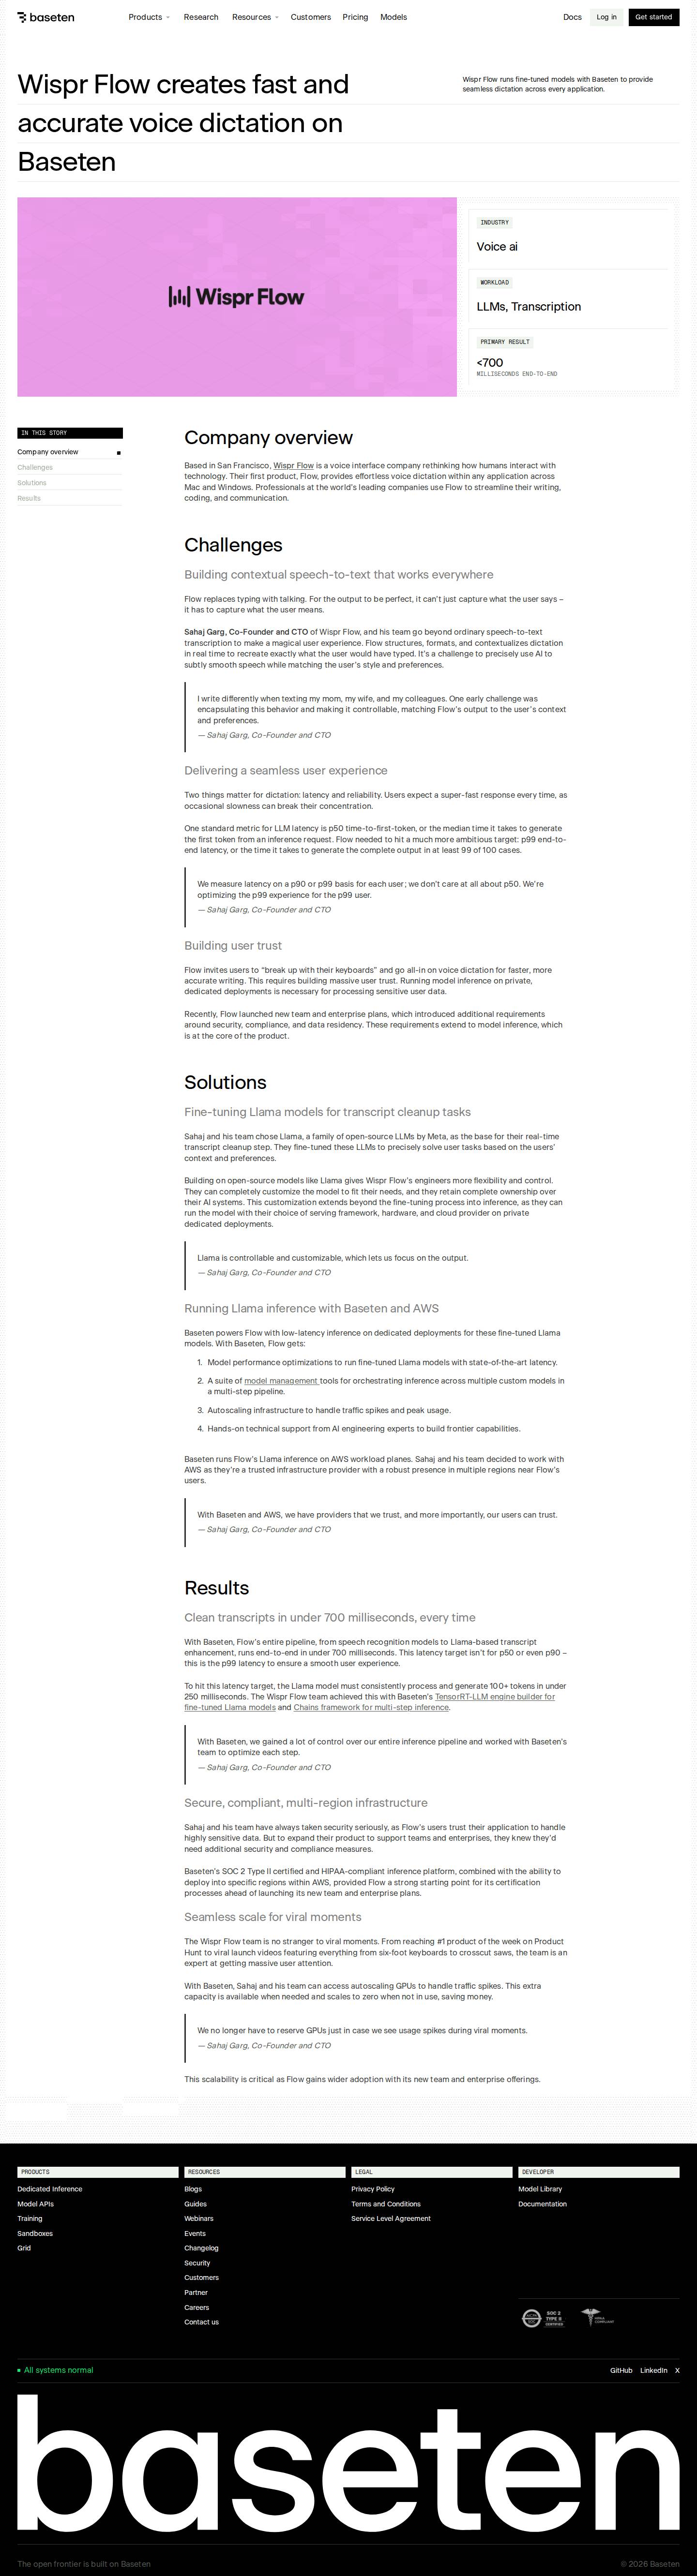 Abrir la captura
Lo que dice la historia, y lo que verificamos
Lo que comparamos con la página.
- La cifra: 700 millisecondsVerificado
Impresa palabra por palabra en la página, cerca del nombre de Wispr Flow.
- El pasaje citado arribaVerificado
Copiado palabra por palabra de la página, cerca del nombre de Wispr Flow.
- Wispr Flow usa BasetenVerificado
Línea de nivel Confirmado.
- El resultado en síNo verificado
Lo citamos; no lo medimos.
With Baseten, Flow’s entire pipeline, from speech recognition models to Llama-based transcript enhancement, runs end-to-end in under 700 milliseconds. This latency target isn’t for p50 or even p90 – this is the p99 latency to ensure a smooth user experience.