Comment OpenEvidence utilise Baseten
OpenEvidence exécute sur Baseten l'inférence de sa plateforme de recherche médicale par IA, qui traite des charges de travail de LLM et d'embeddings pour les cliniciens. Elle utilise aussi Baseten Training pour l'entraînement de ses modèles et s'appuie sur une gestion de capacité multicloud pour absorber les pics de trafic.
Voir la preuve capturéeL’usage : comment OpenEvidence déploie Baseten
OpenEvidence runs inference for its AI medical search platform on Baseten, serving LLM and embedding workloads for clinicians. It also uses Baseten Training for model training and relies on multi-cloud capacity management to handle traffic spikes.
Autres résultats publiés
Chiffres publiés dans l’étude de cas de Baseten. usedby ne les mesure pas de façon indépendante.
6x faster deployment processes, from multiple engineers spending hours on a deployment to one engineer spending less than an hour
8x+ reduction in infrastructure maintenance time overall
With Baseten Embeddings Inference, we immediately saw 3x speed improvements.
Le témoignage du client
Notre équipe a passé des semaines à étudier et à évaluer des fournisseurs d'inférence. Le processus a été rigoureux, et nous sommes convaincus que Baseten s'impose clairement.Traduction automatique de l’anglaisVoir l’original
Our team spent weeks researching and vetting inference providers. It was a thorough process and we confidently believe Baseten is a clear winner.Baseten nous a aidés à entraîner des modèles 23 fois plus vite et devrait nous faire économiser 1,9 M$, tout en rendant le processus si simple que même des ingénieurs non spécialistes du ML ont pu obtenir des résultats en moins de 30 minutes.Traduction automatique de l’anglaisVoir l’original
Baseten helped us train models to be 23x faster and is projected to save us $1.9M—while making the process so easy that even non-ML engineers could get results in under 30 minutes.Baseten prend en charge chaque semaine des milliards d'appels à des LLM personnalisés et affinés pour OpenEvidence, qui fournit des informations médicales à fort enjeu aux professionnels de santé dans tous les grands établissements de santé du pays. Si vous consultez un médecin aujourd'hui, il y a de fortes chances qu'il s'appuie sur OpenEvidence pour obtenir des informations médicales à jour.Traduction automatique de l’anglaisVoir l’original
Baseten supports billions of custom, fine-tuned LLM calls per week from OpenEvidence, serving high-stakes medical information to healthcare providers in every major healthcare facility in the country. If you see a doctor today, chances are that they are leveraging OpenEvidence for up-to-date medical information.Aucun autre produit ne permet de lancer dix tâches d'entraînement différentes sur quatre jeux de données différents. On peut faire varier tout ce qui nous importe pour repérer ce qui compte vraiment. Et on ne paie le calcul que lorsqu'on l'utilise, ce qui rend ce processus évolutif pour nous. Cela a énormément simplifié l'entraînement. Avant, ç'aurait été tout simplement impossible.Traduction automatique de l’anglaisVoir l’original
No other product lets you launch ten different training jobs on four different datasets. You can sweep anything that you care about to get signal on what’s important. And you only have to pay for compute when you use it, which makes this a scalable process for us. It’s made training so much easier. It would have basically been impossible to do before.Les autres outils IA utilisés par OpenEvidence
Autres relations publiques recensées sur usedby.
Explorer la stack IA de OpenEvidence
Les clients de Baseten dans le secteur HealthTech et santé numérique
Des entreprises du même secteur, avec une preuve publique.
Voir tous les clients de Baseten
Consulter la source
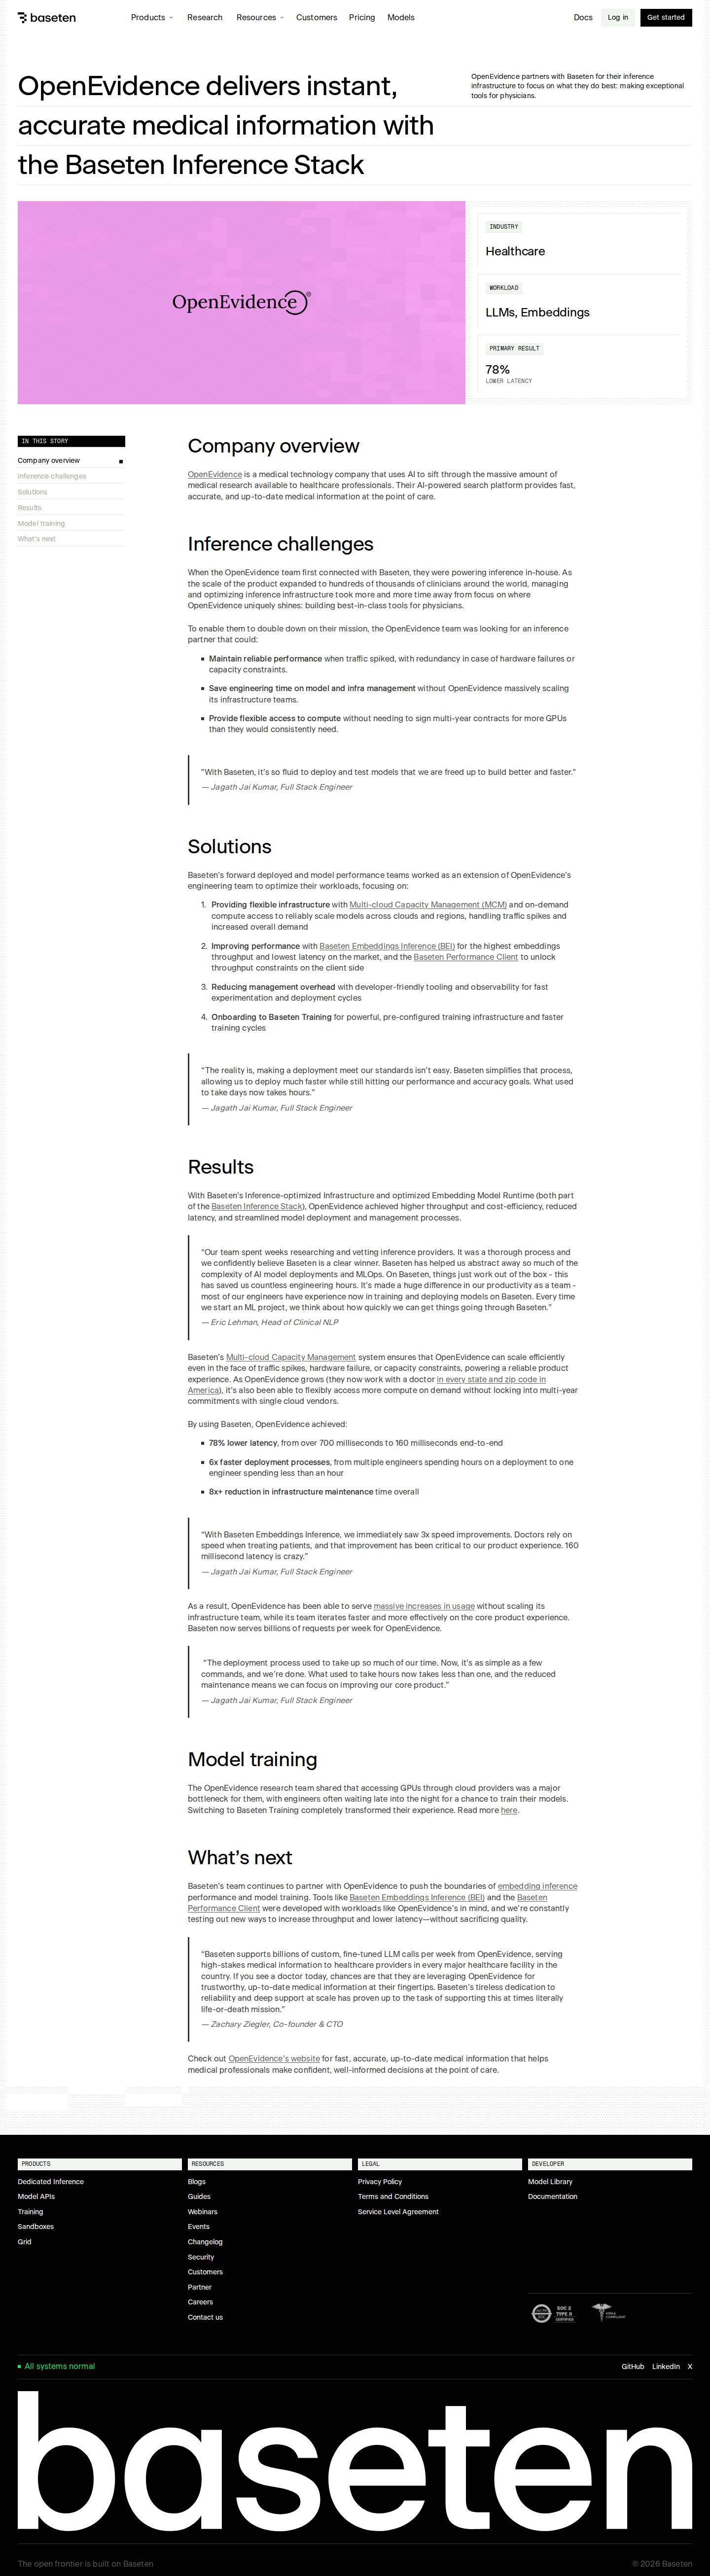
Cette synthèse repose sur l’étude de cas publiée par Baseten. Nous vérifions la preuve publique ; les résultats sont ceux rapportés par l’éditeur.
baseten.co- Dernière vérification
- 11 nov. 2026
 Ouvrir la capture
Ce que dit le témoignage, et ce que nous avons vérifié
Ce que nous avons comparé à la page.
- Le chiffre : 78%Vérifié
Imprimé mot pour mot sur la page, près du nom de OpenEvidence.
- L’extrait cité plus hautVérifié
Copié mot pour mot depuis la page, près du nom de OpenEvidence.
- OpenEvidence utilise BasetenVérifié
Ligne de niveau Confirmé.
- Le résultat lui-mêmeNon vérifié
Nous le citons ; nous ne l’avons pas mesuré.
By using Baseten, OpenEvidence achieved: 78% lower latency, from over 700 milliseconds to 160 milliseconds end-to-end