O caso de uso: como Cartesia implanta Together AI
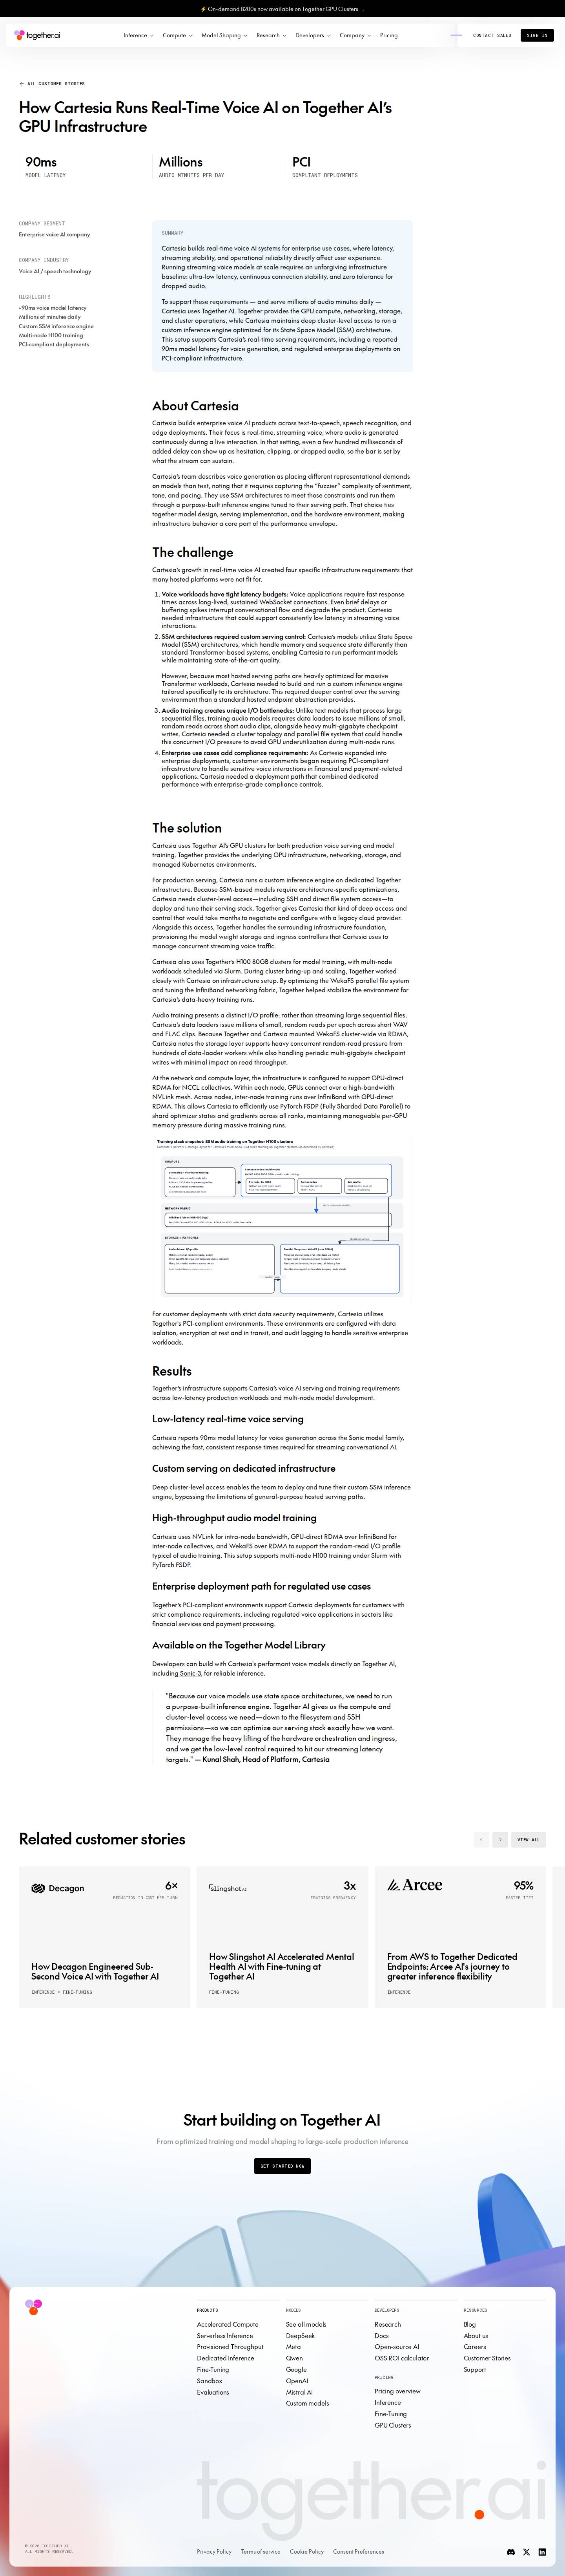
Cartesia runs production real-time voice serving and model training on Together AI's GPU clusters. It operates a custom inference engine for its State Space Model architecture with cluster-level access, and uses PCI-compliant environments for regulated enterprise customers.
Nas palavras do cliente
Because our voice models use state space architectures, we need to run a purpose-built inference engine. Together AI gives us the compute and cluster-level access we need—down to the filesystem and SSH permissions—so we can optimize our serving stack exactly how we want. They manage the heavy lifting of the hardware orchestration and ingress, and we get the low-level control required to hit our streaming latency targets.Outras ferramentas de IA usadas por Cartesia
Outras relações públicas registradas no usedby.
Explorar a stack de IA de Cartesia
Usuários de Together AI no setor Inteligência artificial
Empresas do mesmo setor, com evidências públicas.
 Arcee AIConfirmado
 DecagonConfirmado
 Deep CogitoConfirmado
 Dippy AIConfirmado
 HedraConfirmado
 LegionEdgeConfirmado
Ir direto à fonte
Com base no estudo de caso publicado por Together AI. Verificamos as evidências públicas; os resultados são informados pelo fornecedor.
together.ai- Última verificação
- 3 de out. de 2026
 Abrir a captura da fonte
O que o estudo de caso afirma e o que verificamos
O que comparamos com a página.
- O trecho citado acimaVerificado
Copiado palavra por palavra da página, perto do nome de Cartesia.
- Cartesia usa Together AIVerificado
Linha de nível Confirmado.
- O resultado em siNão verificado
Nós o citamos; não o medimos.
Cartesia reports 90ms model latency for voice generation across the Sonic model family, achieving the fast, consistent response times required for streaming conversational AI.